• Saltar al contenido principal
  • Skip to secondary menu
  • Saltar a la barra lateral principal
  • Saltar al pie de página
  • Inicio
  • Secciones
    • Ciencia de datos
    • Criptografía
    • Herramientas
    • Machine Learning
    • Noticias
    • Opinión
    • Productividad
    • Programación
      • JavaScript
      • Julia
      • Matlab
      • Python
      • R
  • Programación
    • JavaScript
    • Julia
    • Matlab
    • Python
    • R
  • Laboratorio
    • Estadística
      • Calculadora del Tamaño Muestral en Encuestas
      • Calculadora de estadísticos descriptivos
      • Test de normalidad
      • Calculadora de contrastes de hipotesis
      • Calculadora de tamano del efecto
      • Simulador de Regresión Lineal con Ruido
      • Visualizador de PCA
      • Visualizador de Series Temporales
      • Simulador de Regresión Logística
      • Simulador de K-Means
      • Simulador de DBSCAN
      • Detector de la Ley de Benford
      • Ajuste de Curvas
      • Calculadora de Matrices
    • Probabilidad
      • Calculadora de Probabilidad de Distribuciones
      • Calculadora de Probabilidades de Lotería
      • Simulador del Problema de Monty Hall
      • Simulador de la Estrategia Martingala
    • Finanzas
      • Calculadora de Préstamos e Hipotecas
      • Conversor TIN ↔ TAE
      • Calculadora DCA con ajuste por inflación
      • Calculadora XIRR con Flujos Irregulares
      • Simulador FIRE (Financial Independence, Retire Early)
    • Negocios
      • CLV
      • Scoring
    • Herramientas
      • Formateador / Minificador de JSON
      • Conversor CSV ↔ JSON
      • Comparador y Formateador de Texto y JSON
      • Formateador y Tester de Expresiones Regulares
      • Inspector de JWT
      • Generador y verificador de hashes
      • Codificador / Decodificador Base64 y URL
      • Conversor de bases numericas
      • Conversor de Timestamp Unix
      • Conversor de colores
      • Generador de UUIDs
    • Juegos
      • Tres en Raya
      • Nim con Q-Learning
    • Más
      • Método D’Hondt
      • Generador de Contraseñas Seguras
  • Noticias
  • Boletín
  • Contacto
  • Tienda
    • Libros
    • Equipamiento de oficina
    • Equipamiento en movilidad

Analytics Lane

Ciencia e ingeniería de datos aplicada

  • Ciencia de datos
  • Machine Learning
  • IA Generativa
  • Python
  • Pandas
  • NumPy
  • R
  • Excel

Curiosidad: La Paradoja de Simpson, o por qué no siempre debes fiarte de los promedios

Curiosidades

septiembre 18, 2025 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 3 minutos

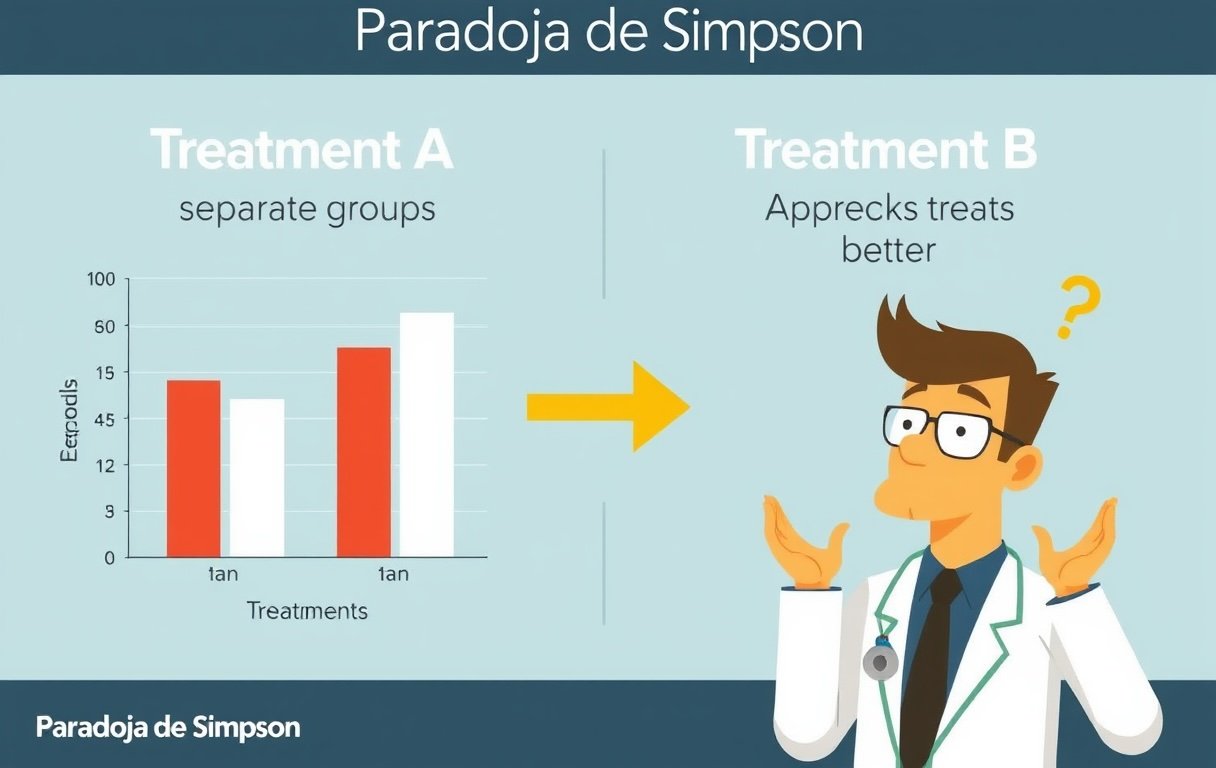
En ciencia de datos y estadística, los promedios y porcentajes son herramientas fundamentales para resumir información… pero a veces pueden jugarte una mala pasada. La Paradoja de Simpson es uno de esos casos fascinantes donde los datos nos muestran una verdad a medias, o incluso directamente equivocada, dependiendo de cómo los agrupamos.

Se trata de un fenómeno en el que una tendencia que aparece claramente en varios grupos separados desaparece o se invierte cuando los datos se combinan. ¿Cómo es posible? La respuesta está en las variables ocultas y en la forma en que agregamos los datos.

Un ejemplo clásico (y real): tratamientos médicos

Supón que estás analizando la eficacia de dos tratamientos para una enfermedad, A y B, diferenciando por sexo. Los datos muestran lo siguiente:

  • En hombres:
    • Tratamiento A: 90% de éxito
    • Tratamiento B: 85% de éxito
  • En mujeres:
    • Tratamiento A: 75% de éxito
    • Tratamiento B: 70% de éxito

Hasta aquí, A gana claramente en ambos grupos. Pero al combinar los datos sin distinción de sexo, aparece un giro inesperado en los resultados del estudio:

  • En total:
    • Tratamiento A: 78% de éxito
    • Tratamiento B: 80% de éxito

¡Ahora B parece mejor!

Esto ocurre, por ejemplo, si A se aplicó principalmente en casos graves (más comunes en mujeres, donde tuvo menor éxito relativo), y B se usó más en casos leves. Así, el promedio global está sesgado por la distribución desigual de los grupos.
Desbalanceo de Clases en Credit Scoring: Por Qué Usamos Ponderación en lugar de Undersampling
En Analytics Lane
Desbalanceo de Clases en Credit Scoring: Por Qué Usamos Ponderación en lugar de Undersampling

¿Por qué sucede esto?

La clave de la Paradoja de Simpson está en una variable oculta o de agrupamiento —como el sexo, la gravedad del caso, la edad, etc.— que influye fuertemente en los resultados. Si ignoramos esta variable y simplemente combinamos los datos, estamos mezclando peras con manzanas, lo que lleva a conclusiones engañosas.

La paradoja nos obliga a considerar algo fundamental en análisis de datos:

La forma en que agrupamos y desglosamos los datos afecta directamente a las conclusiones que podemos sacar.

Publicidad


¿Qué implicaciones tiene?

La Paradoja de Simpson es más que una curiosidad estadística. Puede tener consecuencias reales y graves en múltiples áreas:

  • Medicina: Decidir qué tratamiento usar según análisis incorrectos.
  • Educación: Evaluar la eficacia de programas sin tener en cuenta factores socioeconómicos.
  • Justicia: Interpretar estadísticas de arrestos sin considerar distribución demográfica.
  • Negocios: Sacar conclusiones erróneas de métricas de rendimiento sin segmentar por cliente o canal.

Incluso ha jugado un papel en debates históricos: uno de los ejemplos más citados es el caso de admisión a la Universidad de California, Berkeley, en los años 70, donde los datos agregados sugerían discriminación contra mujeres, pero los análisis por departamentos revelaban lo contrario (¡otra vez la paradoja en acción!).

¿Cómo evitar caer en la trampa?

Para evitar caer en la trampa de la Paradoja de Simpson es importante seguir los siguientes pasos al realizar cualquier análisis de datos:

  1. Segmenta siempre que puedas: Analiza subgrupos relevantes antes de sacar conclusiones globales.
  2. Busca variables de confusión: ¿Hay algo que pueda estar afectando los resultados además de lo que estás midiendo?
  3. Visualiza los datos: Un buen gráfico puede mostrarte relaciones que los promedios ocultan.
  4. Hazte la pregunta incómoda: ¿Y si el patrón desaparece al desagregar?
  5. Consulta con cuidado: Nunca confíes ciegamente en un solo resumen estadístico.

Conclusión

La Paradoja de Simpson es un recordatorio de que los datos no solo deben ser recopilados y analizados, sino también interpretados con contexto. Lo que parece una tendencia sólida puede volverse completamente falsa al mirar más de cerca.

En el mundo de la ciencia de datos, donde las decisiones pueden tener grandes repercusiones, reconocer estas paradojas no es solo interesante: es fundamental para no tomar decisiones equivocadas con datos que “parecen” correctos.

Nota: La imagen de este artículo fue generada utilizando un modelo de inteligencia artificial.

¿Te ha parecido de utilidad el contenido?

¡Puntúalo entre una y cinco estrellas!

Puntuación promedio 5 / 5. Votos emitidos: 1

Ya que has encontrado útil este contenido...

¡Síguenos en redes sociales!

¡Siento que este contenido no te haya sido útil!

¡Déjame mejorar este contenido!

Dime, ¿cómo puedo mejorar este contenido?

Publicidad


Publicaciones relacionadas

  • Desbalanceo de Clases en Credit Scoring: Por Qué Usamos Ponderación en lugar de Undersampling
  • Por Qué las Contraseñas Largas son más Seguras que las Complejas
  • Champion vs Challenger: Cómo los Bancos Validan Modelos Nuevos antes de Ponerlos en Producción
  • Gini, KS y AUC: Cómo Medir la Calidad de un Modelo de Credit Scoring
  • Errores habituales al trabajar con DataFrames grandes en Pandas (y cómo evitarlos)
  • BG/NBD + Gamma/Gamma: el modelo probabilístico para CLV en compras continuas
  • Curiosidad: De dónde vienen foo, bar y foobar
  • Curiosidad: El “bug”, la polilla y la leyenda de Grace Hopper
  • Curiosidad: Por qué la criptografía habla siempre de Alice y Bob

Publicado en: Ciencia de datos, Opinión Etiquetado como: Curiosidades

Interacciones con los lectores

Deja una respuesta Cancelar la respuesta

Tu dirección de correo electrónico no será publicada. Los campos obligatorios están marcados con *

I accept the Terms and Conditions and the Privacy Policy

Este sitio usa Akismet para reducir el spam. Aprende cómo se procesan los datos de tus comentarios.

Barra lateral principal

Suscríbete a nuestro boletín

Suscríbete al boletín semanal para estar al día de todas las publicaciones.

Política de Privacidad

Analytics Lane en redes sociales

  • Amazon
  • Bluesky
  • Facebook
  • GitHub
  • Instagram
  • Mastodon
  • Pinterest
  • RSS
  • Telegram
  • Tumblr
  • Twitter
  • YouTube

Publicidad

Entradas recientes

Curiosidad: Por qué la criptografía habla siempre de Alice y Bob

septiembre 3, 2026 Por Daniel Rodríguez

Desbalanceo de Clases en Credit Scoring: Por Qué Usamos Ponderación en lugar de Undersampling

septiembre 1, 2026 Por Daniel Rodríguez

Curiosidad: El “bug”, la polilla y la leyenda de Grace Hopper

agosto 27, 2026 Por Daniel Rodríguez

Publicidad

Es tendencia

  • NumPy NumPy: Concatenar matrices en NumPy con np.concatenate() publicado el agosto 17, 2021 | en Python
  • Cómo desinstalar Oracle Database 19c en Windows publicado el noviembre 25, 2022 | en Herramientas
  • pandas Eliminar las filas con valores nulos en Pandas publicado el abril 24, 2023 | en Python
  • Codificación JSON Archivos JSON con Python: lectura y escritura publicado el julio 16, 2018 | en Python
  • Dependencies y PeerDependencies en Node.js: Guía completa para entender y usar correctamente las dependencias publicado el enero 22, 2025 | en JavaScript

Publicidad

Lo mejor valorado

4.9 (24)

Seleccionar filas y columnas en Pandas con iloc y loc

4.6 (16)

Archivos JSON con Python: lectura y escritura

4.4 (14)

Ordenación de diccionarios en Python mediante clave o valor

4.7 (13)

Operaciones de filtrado de DataFrame con Pandas en base a los valores de las columnas

4.1 (11)

Aplicar el método D’Hondt en Excel

Comentarios recientes

  • Daniel Rodríguez en Los récords con asterisco, o la épica del titular sin contexto – El bestiario de los indicadores económicos absurdos (parte 8 y final)
  • Juan en Los récords con asterisco, o la épica del titular sin contexto – El bestiario de los indicadores económicos absurdos (parte 8 y final)
  • bif en JSON en bases de datos: cuándo es buena idea y cuándo no
  • bif en Cómo desinstalar Oracle Database 19c en Windows
  • M. Pilar en Cómo eliminar las noticias en Windows 11 y recuperar tu concentración

Publicidad


Footer

Analytics Lane

  • Acerca de Analytics Lane
  • Boletín de noticias
  • Contacto
  • Libros
  • Lo más popular
  • Noticias
  • Tienda
  • Tiendas afiliadas

Secciones

  • Ciencia de datos
  • Criptografía
  • Herramientas
  • Machine Learning
  • Opinión
  • Productividad
  • Programación
  • Reseñas

Sobre de Analytics Lane

En Analytics Lane tratamos de explicar los principales conceptos de la ciencia e ingeniería de datos con un enfoque práctico. Los principales temas tratados son ciencia de datos, ingeniería de datos, inteligencia artificial, machine learning, deep learning y criptografía. Además, también se habla de los principales lenguajes de programación y herramientas utilizadas por los científicos e ingenieros de datos.

Copyright © 2018-2026 Analytics Lane ·Términos y condiciones ·Política de Cookies ·Política de Privacidad ·Herramientas de privacidad ·Contacto