"Nuestros datos no tienen buena calidad."Escuchas esto constantemente en reuniones. El problema es que casi nadie dice exactamente qué significa eso. ¿Son datos incompletos? ¿Inconsistentes? ¿Viejos? ¿Irrelevantes? ¿Todo a la vez?La frase "calidad de datos" se usa como paraguas para tapar agujeros muy distintos, y ese es precisamente el problema. En Machine Learning, … [Leer más...] acerca de Qué significa realmente “calidad de datos”
Ciencia de datos
La ciencia de datos es un área de conocimiento interdisciplinar en el cual se utilizan procesos para recopilar, preparar, analizar, visualizar y modelar datos para extraer todo su valor. Pudiéndose emplear tanto con conjuntos de datos estructurados como no estructurados. Los científicos de datos, los profesionales de esta área deben poseer grandes conocimientos de estadística e informática. Además de conocimiento de los procesos que están modelando.
Con la ciencia de datos es posible revelar tendencias y obtener información para que tanto las empresas como las instituciones puedan tomar mejores decisiones. Basando estas así en conocimiento validado no en intuiciones.
Las publicaciones de esta sección abarca diferentes temas de áreas como la estadística, la minería de datos, el aprendizaje automático y la analítica predictiva.
Cómo Detectar Pseudo-IDs y Data Leakage en el Constructor de Scorecards
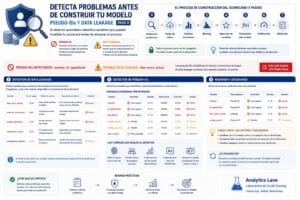
El artículo Data Leakage en Credit Scoring explicó por qué este es el error más silencioso y más costoso en la construcción de un scorecard: un modelo contaminado con información del futuro puede mostrar métricas de validación excelentes y ser completamente inútil en producción.Este tutorial muestra cómo usar el detector automático del constructor de scorecards del … [Leer más...] acerca de Cómo Detectar Pseudo-IDs y Data Leakage en el Constructor de Scorecards
Cómo Verificar la Normalidad de tus Datos antes de un Test Estadístico
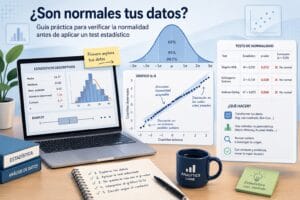
Antes de aplicar muchos tests estadísticos clásicos (el t-test, el ANOVA, la regresión lineal) aparece un supuesto que con frecuencia se ignora o se verifica de forma superficial: que los datos siguen una distribución normal. Si ese supuesto se viola de forma grave, las conclusiones del test pueden ser incorrectas, p-valores que no significan lo que parecen, intervalos de … [Leer más...] acerca de Cómo Verificar la Normalidad de tus Datos antes de un Test Estadístico
Cómo construir tu primer scorecard paso a paso
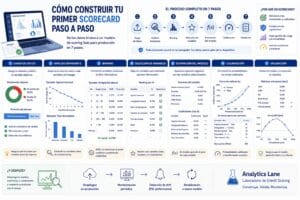
En los artículos anteriores de esta serie vimos la teoría detrás del credit scoring: qué son el WOE y el IV, cómo funciona el binning, cómo se transforma una regresión logística en un scorecard, qué diferencia la calibración de la discriminación y cómo monitorizar un modelo en producción. En este tutorial conectamos toda esa teoría con la práctica: construiremos un scorecard … [Leer más...] acerca de Cómo construir tu primer scorecard paso a paso
Pareto/NBD: cuando el abandono silencioso cambia el CLV
En el artículo del Dashboard vimos que Pareto/NBD aparecía junto a BG/NBD con un ajuste estadístico casi idéntico (log-verosimilitud -17.135,8 vs -17.138,2) pero un CLV medio bastante más bajo (15 € vs 29 €). Quedó pendiente explicar por qué. Este artículo cierra ese hueco: la diferencia entre ambos modelos no está en cómo se ajustan a los datos observados, sino en qué asumen … [Leer más...] acerca de Pareto/NBD: cuando el abandono silencioso cambia el CLV
Método del codo: interpretación correcta y limitaciones
Cuando usas k-means tienes que decidir algo incómodo de entrada: cuántos grupos, , vas a buscar en el conjunto de datos. Y como el algoritmo no lo decide por ti, casi todo el mundo recurre al mismo truco: el método del codo. Dibujas una curva, buscas el "punto donde se dobla" y ese es tu número de clusters. Rápido, visual y aparentemente objetivo.El problema es que el … [Leer más...] acerca de Método del codo: interpretación correcta y limitaciones
Errores comunes al interpretar resultados estadísticos
La estadística no suele fallar en los cálculos: falla en la interpretación. El test está bien hecho, el número es correcto… y aun así la conclusión que se saca de él es errónea. Estos malentendidos no son anécdotas de principiante; aparecen en artículos científicos, informes de empresa y, especialmente, titulares de prensa todos los días.En esta entrada reunimos los errores … [Leer más...] acerca de Errores comunes al interpretar resultados estadísticos
Dashboard CLV: cuatro modelos, un mismo dataset, conclusiones muy distintas
Los artículos anteriores de esta serie cubrieron cuatro formas de mirar el valor del cliente: la fórmula clásica de retención, la segmentación RFM, y los modelos probabilísticos BG/NBD y BG/BB. Cada uno responde a una pregunta distinta y descansa en supuestos distintos. El Dashboard del laboratorio los ejecuta todos sobre el mismo conjunto de datos, lo que permite algo que … [Leer más...] acerca de Dashboard CLV: cuatro modelos, un mismo dataset, conclusiones muy distintas
Desbalanceo de Clases en Credit Scoring: Por Qué Usamos Ponderación en lugar de Undersampling
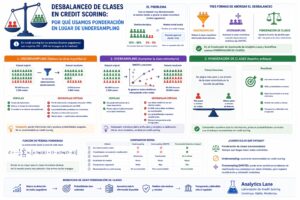
En credit scoring el desbalanceo de clases es la norma, no la excepción. En una cartera de crédito al consumo típica la tasa de default oscila entre el 2% y el 15%. Eso significa que por cada cliente que impaga hay entre 6 y 50 que pagan correctamente. El dataset de entrenamiento refleja esa realidad y esa asimetría plantea un problema técnico concreto al ajustar el … [Leer más...] acerca de Desbalanceo de Clases en Credit Scoring: Por Qué Usamos Ponderación en lugar de Undersampling
BG/BB: el modelo de CLV para compras en períodos discretos
Los dos artículos anteriores de la serie cubrieron BG/NBD, el modelo para negocios donde el cliente puede comprar en cualquier momento con frecuencia libre. Pero no todos los negocios funcionan así. Hay un grupo amplio de contextos (donaciones a campañas periódicas, renovaciones de membresía, compras de catálogo estacional) donde el cliente no decide "cuándo" comprar, sino "si … [Leer más...] acerca de BG/BB: el modelo de CLV para compras en períodos discretos
Gini, KS y AUC: Cómo Medir la Calidad de un Modelo de Credit Scoring
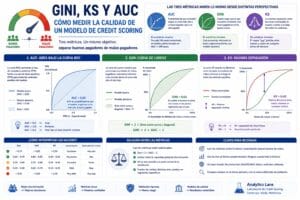
Cuando un analista de riesgo presenta un nuevo scorecard ante el comité de dirección, la primera pregunta que recibe es invariablemente la misma: ¿cómo de bueno es el modelo? La respuesta técnica correcta implica tres métricas: Gini, KS y AUC. Con la que se mide la capacidad del modelo de separar a los buenos pagadores de los malos pagadores.Estas tres métricas son las más … [Leer más...] acerca de Gini, KS y AUC: Cómo Medir la Calidad de un Modelo de Credit Scoring
BG/NBD + Gamma/Gamma: el modelo probabilístico para CLV en compras continuas
Los dos artículos anteriores cubrieron el CLV clásico —una fórmula útil pero que trata a toda la cartera con la misma tasa de retención— y la segmentación RFM —que clasifica a cada cliente según su comportamiento pasado pero no predice su comportamiento futuro—. Este artículo cierra esa brecha con el modelo que es, hoy, el estándar de referencia para CLV en negocios no … [Leer más...] acerca de BG/NBD + Gamma/Gamma: el modelo probabilístico para CLV en compras continuas