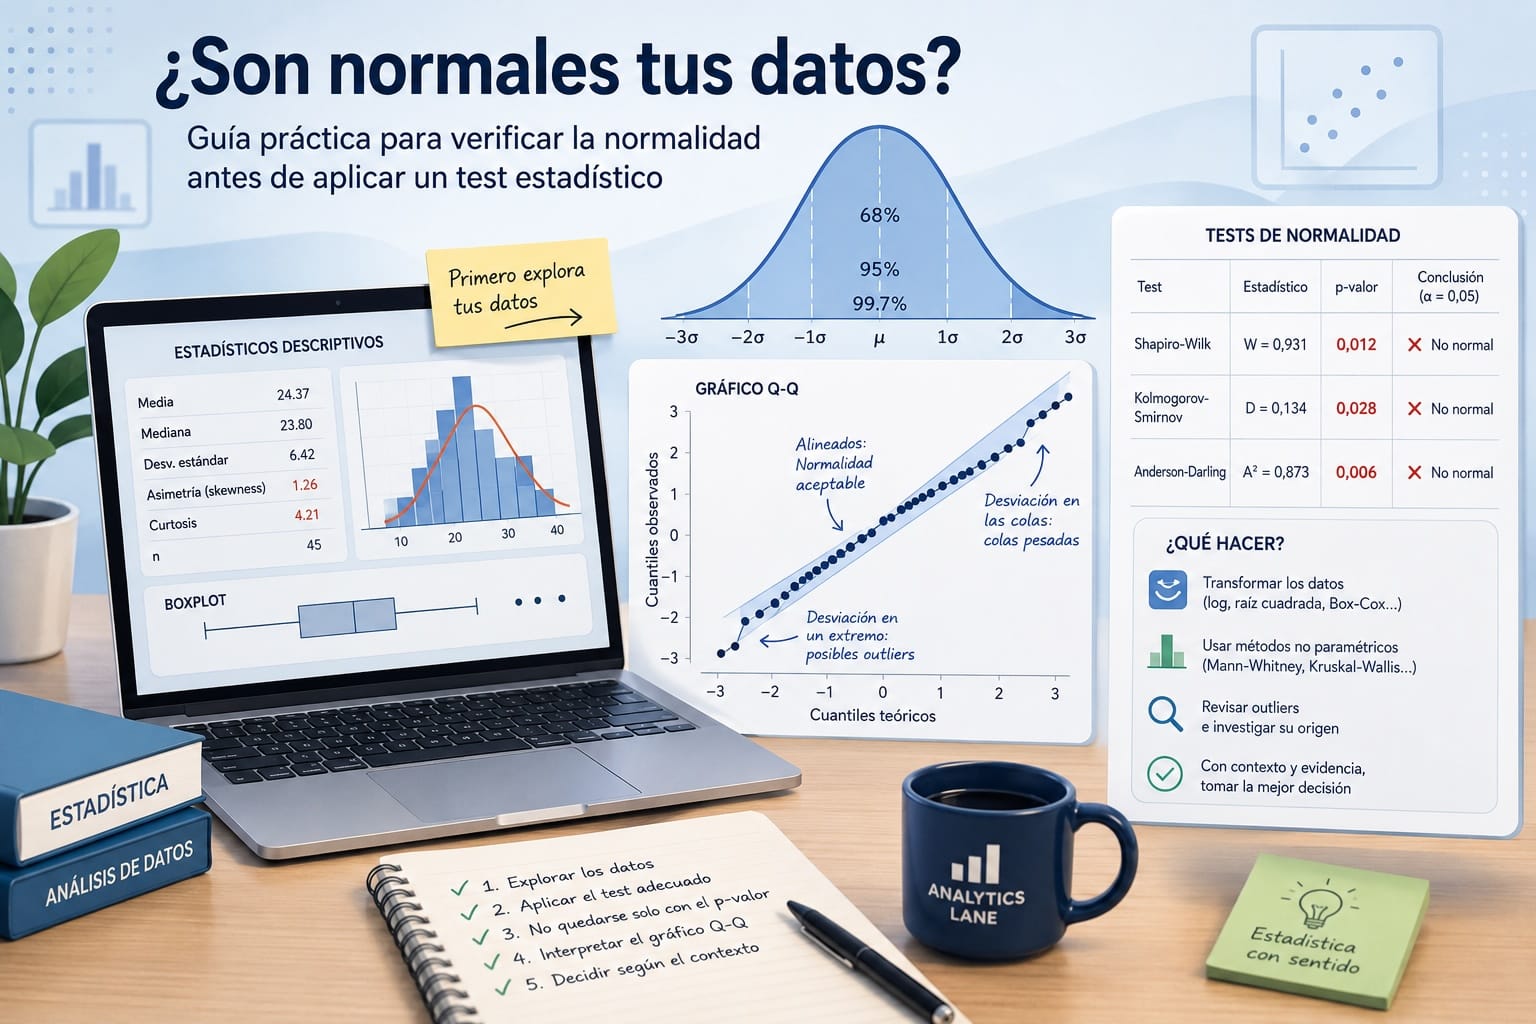
Antes de aplicar muchos tests estadísticos clásicos (el t-test, el ANOVA, la regresión lineal) aparece un supuesto que con frecuencia se ignora o se verifica de forma superficial: que los datos siguen una distribución normal. Si ese supuesto se viola de forma grave, las conclusiones del test pueden ser incorrectas, p-valores que no significan lo que parecen, intervalos de confianza mal calculados, decisiones equivocadas.
Pero verificar la normalidad tampoco es tan sencillo como mirar un histograma y decidir que “parece una campana”. Hay herramientas más rigurosas, tests formales y gráficos diagnósticos, y hay que saber interpretar sus resultados correctamente.
Este tutorial muestra cómo verificar la normalidad de tus datos usando la aplicación de test de normalidad del laboratorio de Analytics Lane, que implementa los tres tests más usados (Shapiro-Wilk, Kolmogorov-Smirnov y Anderson-Darling) junto con el gráfico Q-Q, y cómo conectar el resultado con la calculadora de estadísticos descriptivos cuando necesitas más contexto sobre tus datos.
Cuándo importa la normalidad y cuándo no
Antes de abrir la app, vale la pena hacerse la pregunta: ¿realmente necesito verificar la normalidad en este caso?
Algo que es importante cuando:
- Vas a aplicar un t-test de una o dos muestras con n pequeño (menos de 30-40 observaciones)
- Vas a aplicar un ANOVA
- Quieres calcular intervalos de confianza paramétricos exactos
- El modelo que vas a ajustar asume residuos normales (regresión lineal clásica)
Pero importa menos cuando:
- Tu muestra es grande (más de 30-50 observaciones), el teorema central del límite garantiza que la media muestral se distribuye aproximadamente normal aunque los datos no lo sean
- Vas a usar tests no paramétricos (Mann-Whitney, Kruskal-Wallis) que no asumen normalidad
- Estás haciendo análisis exploratorio sin inferencia estadística formal
Con muestras grandes casi cualquier test de normalidad rechazará la hipótesis nula aunque la desviación sea tan pequeña que no tenga ningún impacto práctico en los resultados. Por eso el test formal siempre debe complementarse con el gráfico Q-Q y el juicio del analista, no basta con mirar el p-valor.
Paso 1: Carga tus datos en estadísticos descriptivos
Antes de ir directamente al test de normalidad, el primer paso recomendado es cargar tus datos en la calculadora de estadísticos descriptivos para tener una visión general.
Pega tu columna de datos en el textarea (la aplicacion acepta números separados por comas, espacios o saltos de línea, y también datos copiados directamente desde Excel). Una vez cargados verás:
- La asimetría (skewness), si está muy alejada de 0 (en valor absoluto mayor de 1) es una señal de que los datos probablemente no son normales
- La curtosis, valores muy alejados de 3 (la curtosis de una normal) también son señal de alerta
- El histograma con la curva normal superpuesta, una primera inspección visual muy útil
- El boxplot, los outliers marcados como puntos individuales fuera de los bigotes son señales de colas pesadas
Con esta información ya tienes una intuición sobre si la normalidad es plausible antes de hacer el test formal.
El botón de conexión
En la calculadora de estadísticos descriptivos encontrarás un botón “Test de normalidad →” que transfiere los datos directamente a la app de test de normalidad sin necesidad de copiar y pegar de nuevo. Úsalo para pasar al siguiente paso de forma fluida.
Paso 2: Elige el test apropiado para tu tamaño muestral
En la app de test de normalidad verás los tres tests disponibles junto con el gráfico Q-Q. Antes de interpretar los resultados, conviene saber cuál es el más apropiado para tu caso:
| Tamaño muestral | Test recomendado | Por qué |
|---|---|---|
| n < 50 | Shapiro-Wilk | El más potente para muestras pequeñas |
| 50 ≤ n ≤ 200 | Anderson-Darling | Más potente que KS, especialmente en las colas |
| n > 200 | Cualquiera con precaución | Con n grande todos los tests rechazan H₀ ante desviaciones mínimas |
La app calcula los tres automáticamente y muestra un aviso cuando un test está fuera de su rango óptimo, por ejemplo Shapiro-Wilk con n > 50.
Paso 3: Interpreta los resultados de los tests formales
La tabla de resultados muestra para cada test el estadístico calculado, el p-valor y la conclusión a dos niveles de significación (α = 0,05 y α = 0,01):
| Test | Estadístico | P-valor | α = 0,05 | α = 0,01 |
|---|---|---|---|---|
| Shapiro-Wilk | W = 0,9792 | 0,5195 | ✅ Normal | ✅ Normal |
| Kolmogorov-Smirnov | D = 0,0719 | 0,9513 | ✅ Normal | ✅ Normal |
| Anderson-Darling | A² = 0,2661 | 0,6908 | ✅ Normal | ✅ Normal |
Cómo leer el resultado
Un p-valor alto (> 0,05) significa que no hay evidencia suficiente para rechazar la normalidad, los datos son compatibles con una distribución normal. Pero atención: esto no prueba que los datos sean normales, solo que no tenemos evidencia en contra.
Un p-valor bajo (< 0,05) significa que hay evidencia de que los datos no son normales. Pero con muestras grandes (n > 200) esto puede ocurrir aunque la desviación sea tan pequeña que no afecte en absoluto a los resultados de tu test estadístico.
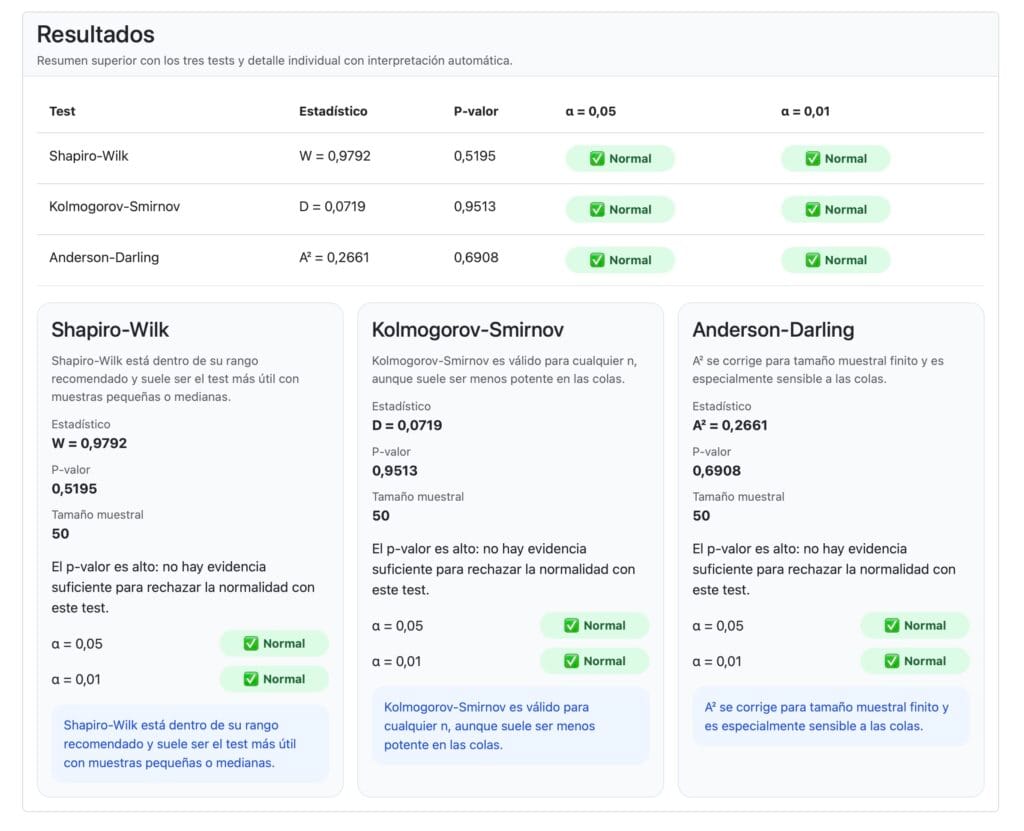
Por eso el p-valor nunca debe interpretarse solo, siempre junto con el gráfico Q-Q.
Paso 4: Interpreta el gráfico Q-Q
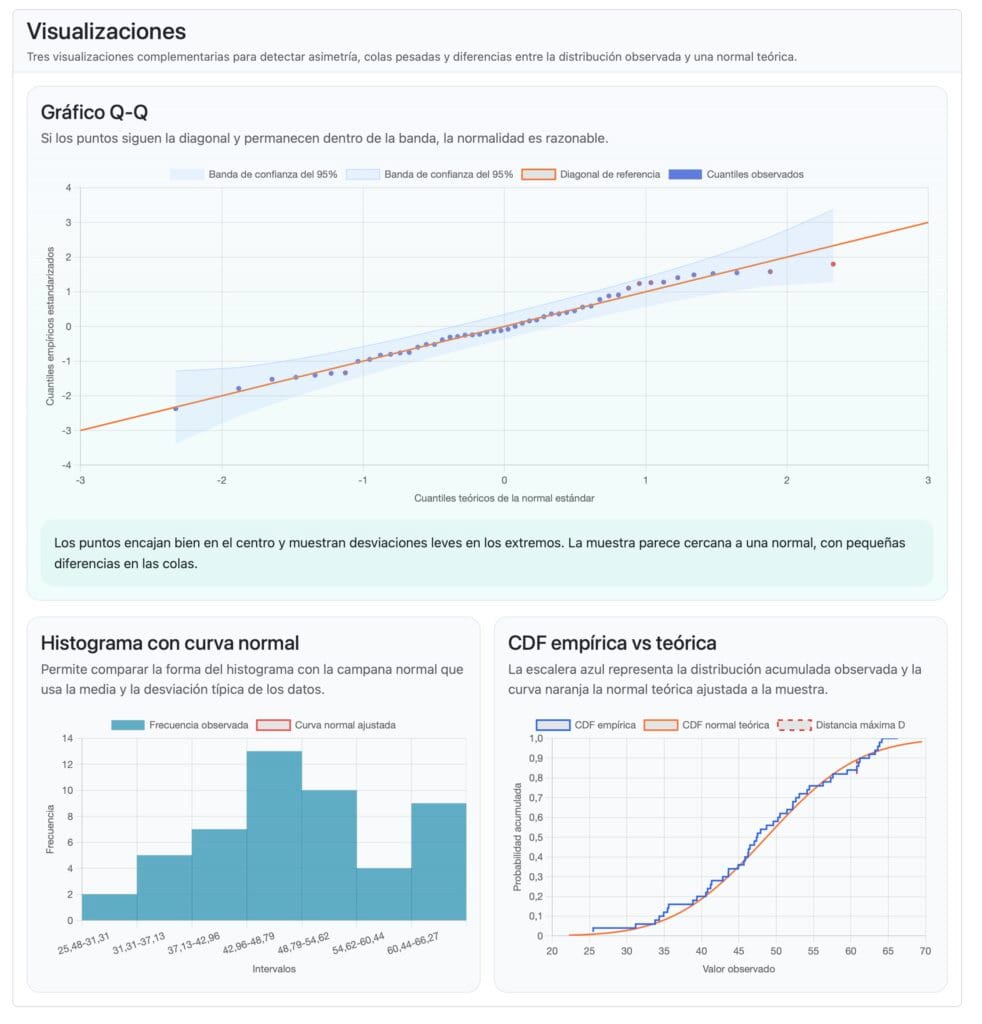
El gráfico Q-Q (quantile-quantile) es la herramienta más informativa del paso, más que cualquier test formal, porque no solo dice si hay desviación sino dónde y de qué tipo.
En el gráfico verás:
- Una línea diagonal de referencia, los puntos deberían seguirla si los datos son normales
- Bandas de confianza al 95% alrededor de la línea, los puntos que caen fuera de las bandas son desviaciones estadísticamente significativas
- Los puntos de los cuantiles de tus datos
Los patrones más frecuentes
- Puntos alineados sobre la diagonal: Los datos son aproximadamente normales. Puedes proceder con los tests paramétricos con confianza.
- Puntos que se curvan hacia arriba en ambos extremos (colas pesadas): La distribución tiene colas más pesadas que la normal, más valores extremos de lo esperado. Distribución leptocúrtica. Puede afectar a los tests paramétricos si las colas son muy pesadas.
- Puntos que se curvan hacia abajo en ambos extremos (colas ligeras): La distribución tiene colas más ligeras que la normal. Distribución platicúrtica. Generalmente menos problemático que las colas pesadas.
- Puntos que siguen una curva en S: Indica asimetría, los datos están sesgados a la derecha o a la izquierda. Si la S es pronunciada considera una transformación logarítmica o raíz cuadrada antes de aplicar tests paramétricos.
- Puntos que se desvían en un extremo pero no en el otro: Asimetría en una sola cola. Puede indicar la presencia de outliers o una distribución genuinamente asimétrica.
Paso 5: Decide qué hacer con el resultado
Una vez tienes los resultados del test y el Q-Q, la decisión depende de la combinación de tres factores: el p-valor, el patrón del Q-Q y el tamaño muestral.
Escenario A — P-valor alto y Q-Q limpio
Los datos son compatibles con la normalidad. Procede con el test paramétrico que tenías planificado.
Escenario B — P-valor bajo pero Q-Q con desviación leve y n grande
Con n grande es esperable que el test rechace H₀ ante desviaciones pequeñas. Si el Q-Q muestra puntos que se alejan poco de la diagonal y están mayoritariamente dentro de las bandas de confianza, la desviación probablemente no afecta a los resultados del test paramétrico. El teorema central del límite te protege con muestras grandes.
Escenario C — P-valor bajo y Q-Q con desviación clara
Aquí hay un problema real. Las opciones son:
- Transformar los datos Si el Q-Q muestra una S pronunciada (asimetría), una transformación logarítmica suele corregirla para variables que solo toman valores positivos. Aplica la transformación, repite el test de normalidad y comprueba si el Q-Q mejora.
- Usar un test no paramétrico: El equivalente no paramétrico del t-test es el test de Mann-Whitney (para dos muestras independientes) o el test de Wilcoxon (para muestras pareadas). No asumen normalidad y son válidos con cualquier distribución.
- Proceder con el test paramétrico con precaución: Si n es moderadamente grande (> 30) y la desviación no es extrema, los tests paramétricos son razonablemente robustos ante violaciones leves de la normalidad. Pero documenta la decisión y sus limitaciones.
Escenario D — P-valor bajo y Q-Q con outliers claros
Si el Q-Q muestra uno o dos puntos muy alejados de la diagonal mientras el resto sigue la línea correctamente, el problema son los outliers, no la distribución subyacente. Identifica esos puntos en tus datos, investiga si son errores de medición o valores genuinos, y decide si excluirlos es justificable.
Ejemplo práctico completo
Supón que tienes los tiempos de respuesta en segundos de un proceso informático medidos en 45 ocasiones y quieres saber si puedes usar un t-test para comparar la media con un valor de referencia.
Lo que ves en estadísticos descriptivos:
- Media: 2,34 segundos
- Asimetría: 1,87, claramente positiva, señal de alerta
- El histograma muestra una cola larga hacia la derecha
Lo que ves en el test de normalidad:
- Shapiro-Wilk: W = 0,891, p-valor = 0,012 → ❌ Rechaza normalidad con α = 0,05
- Q-Q: los puntos forman una S pronunciada, con los valores altos muy por encima de la diagonal
Conclusión:
Los datos no son normales, hay asimetría positiva clara. Con n = 45 el t-test puede verse afectado. Las opciones son:
- Aplicar transformación logarítmica (adecuada para tiempos de proceso) y repetir el test
- Usar el test de Wilcoxon de rango con signo como alternativa no paramétrica
Aplicas la transformación logarítmica, repites el test de normalidad en la app con los valores transformados y obtienes Shapiro-Wilk W = 0,963, p-valor = 0,189, ahora el Q-Q es limpio y puedes aplicar el t-test sobre los datos transformados.
Conclusiónes
El test de normalidad del laboratorio de Analytics Lane junto a la calculadora de estadísticos descriptivos permite realizar análisis estadísticos de una forma rápida y sencilla. Permitiendo por ejemplo, realizar análisis se normalidad e intepretarlos en minutos sin necesidad de codificación.
Resumen del proceso:
- Carga tus datos en estadísticos descriptivos, revisa asimetría, curtosis e histograma
- Usa el botón “Test de normalidad →” para transferir los datos sin copiar y pegar
- Identifica el test más apropiado para tu tamaño muestral (Shapiro-Wilk si n < 50)
- Lee el p-valor pero no te quedes ahí, mira siempre el Q-Q
- Identifica el patrón del Q-Q para entender qué tipo de desviación tienes si la hay
- Decide según la combinación de p-valor, patrón del Q-Q y tamaño muestral
Nota: La imagen de este artículo fue generada utilizando un modelo de inteligencia artificial.
Deja una respuesta