Tienes dos grupos de datos y quieres saber si son estadísticamente distintos. O tienes una muestra y quieres comparar su media con un valor de referencia. O quieres saber si la tasa de conversión de una versión de tu web es realmente mejor que la de otra. En todos estos casos necesitas un test de hipótesis, pero hay decenas de tests distintos y elegir el incorrecto puede llevar a conclusiones equivocadas.
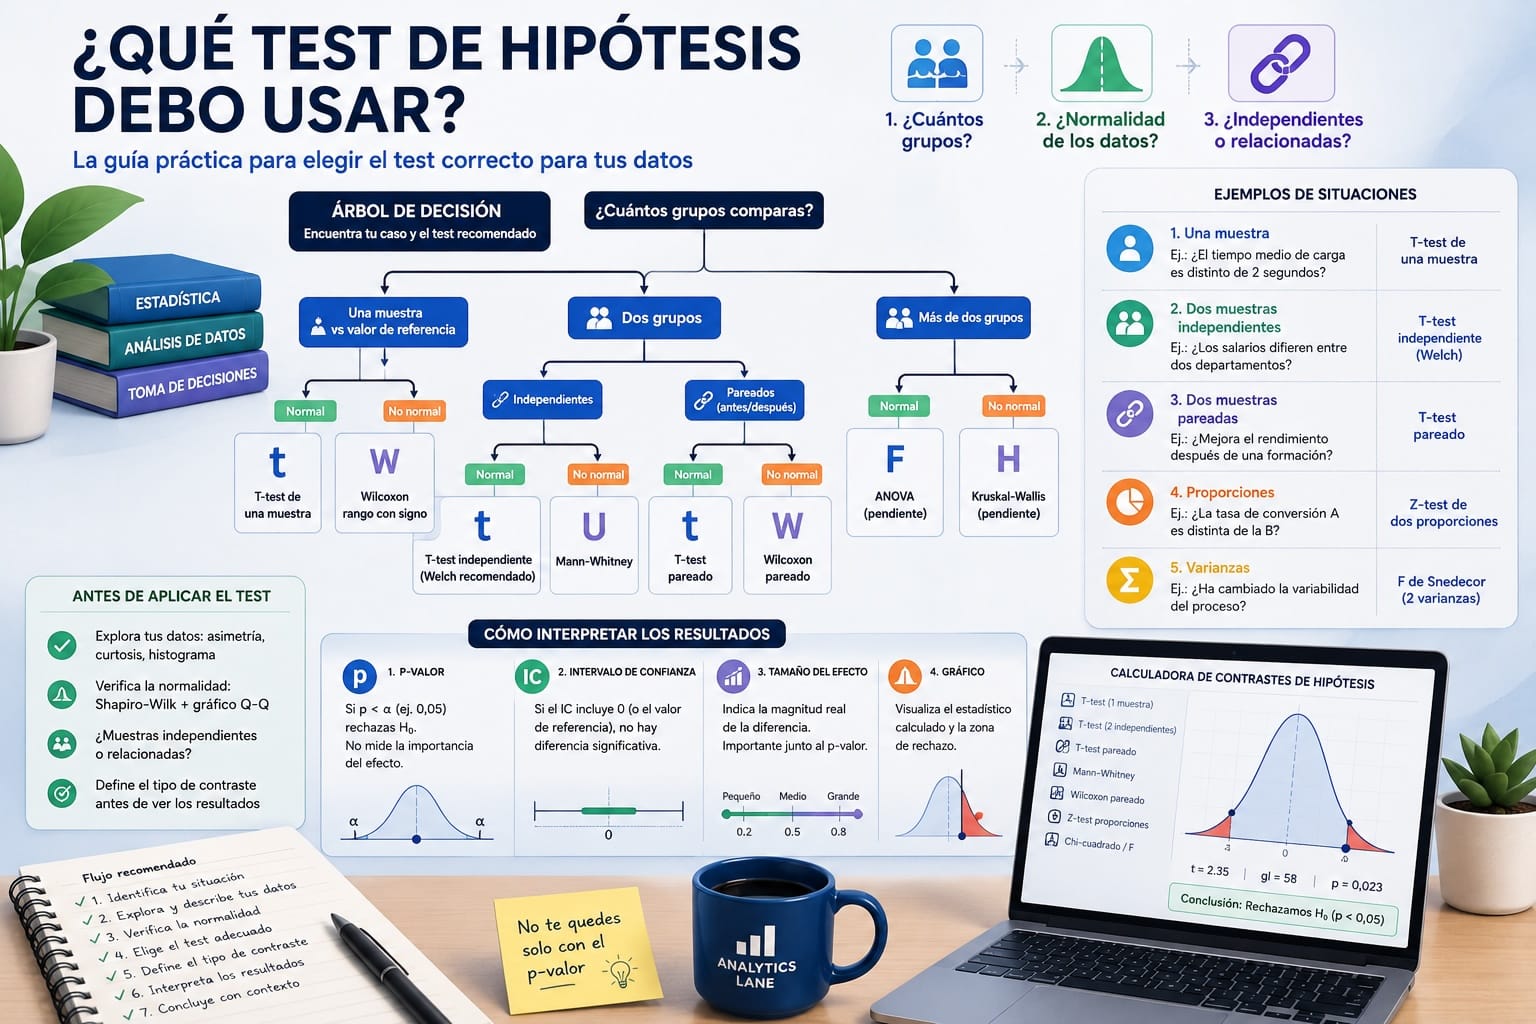
La elección del test correcto depende de tres preguntas fundamentales: ¿cuántos grupos estás comparando? ¿Los datos cumplen el supuesto de normalidad? ¿Las muestras son independientes o están relacionadas entre sí? Con estas tres preguntas resueltas la elección es casi siempre directa.
Este tutorial muestra cómo usar la calculadora de contrastes de hipótesis del laboratorio de Analytics Lane para aplicar el test correcto a tu caso concreto, y cómo conectarla con las otras calculadoras del laboratorio para verificar los supuestos antes de proceder.
El árbol de decisión
Antes de abrir la calculadora, recorre este árbol de decisión con tu caso concreto:
¿Cuántos grupos comparas?
│
├── Una muestra vs valor de referencia
│   ├── Datos normales → T-test de una muestra
│   └── Datos no normales → Test de Wilcoxon de rango con signo
│
├── Dos grupos
│   ├── Muestras independientes
│   │   ├── Datos normales → T-test de dos muestras independientes
│   │   │   ├── Varianzas iguales → Student
│   │   │   └── Varianzas distintas → Welch (recomendado por defecto)
│   │   └── Datos no normales → Test de Mann-Whitney
│   └── Muestras pareadas
│       ├── Datos normales → T-test pareado
│       └── Datos no normales → Test de Wilcoxon de rango con signo (pareado)
│
└── Más de dos grupos
    ├── Datos normales → ANOVA (pendiente en el laboratorio)
    └── Datos no normales → Kruskal-Wallis (pendiente en el laboratorio)
Este árbol cubre las comparaciones de medias, el caso más habitual. Si lo que comparas son proporciones (tasas de conversión, porcentajes de éxito) o varianzas (variabilidad de un proceso), los tests correspondientes se tratan en los casos 4 y 5 de este tutorial.
La calculadora del laboratorio cubre actualmente los tests de una y dos muestras, tanto paramétricos como no paramétricos. Los tests para más de dos grupos (ANOVA y Kruskal-Wallis) están pendientes de implementar.
Antes de elegir el test: verifica los supuestos
La elección entre un test paramétrico (t-test) y uno no paramétrico (Mann-Whitney, Wilcoxon) depende de si tus datos cumplen el supuesto de normalidad. El tutorial Cómo Verificar la Normalidad de tus Datos explica este proceso en detalle. Aquí el resumen:
- Carga tus datos en la calculadora de estadísticos descriptivos
- Usa el botón “Test de normalidad →” para verificar el supuesto
- Si el test rechaza la normalidad y el Q-Q muestra una desviación clara, usa el test no paramétrico equivalente
- Si n > 30 y la desviación es leve, el test paramétrico sigue siendo válido gracias al teorema central del límite
Una vez verificados los supuestos, abre la calculadora de contrastes y usa el botón “← Estadísticos descriptivos” para transferir los datos sin copiar y pegar.
Caso 1: Una muestra vs valor de referencia
Ejemplo: tienes los tiempos de carga de 30 páginas web de tu sitio y quieres saber si la media es significativamente distinta de 2 segundos, el estándar que tu equipo se ha marcado como objetivo.
En la calculadora
Selecciona el test T-test de una muestra en el selector. Introduce o transfiere tus datos en el modo de datos brutos, o introduce directamente n, media y desviación típica en el modo de estadísticos resumen.
En el campo Valor de referencia (μ₀) introduce 2.
Selecciona el tipo de contraste:
- Bilateral (H₁: μ ≠ 2) si no tienes expectativa previa sobre la dirección, el más habitual
- Cola derecha (H₁: μ > 2) si solo te preocupa que el tiempo sea mayor que el estándar
- Cola izquierda (H₁: μ < 2) si solo te preocupa que sea menor
Lo que verás
La calculadora muestra el estadístico t, los grados de libertad, el p-valor y el valor crítico. Más importante: la conclusión en lenguaje natural en dos niveles:
“Con α = 0,05 no se rechaza H₀ (p = 0,234 > 0,05). No hay evidencia suficiente de que la media difiera de 2 segundos.”
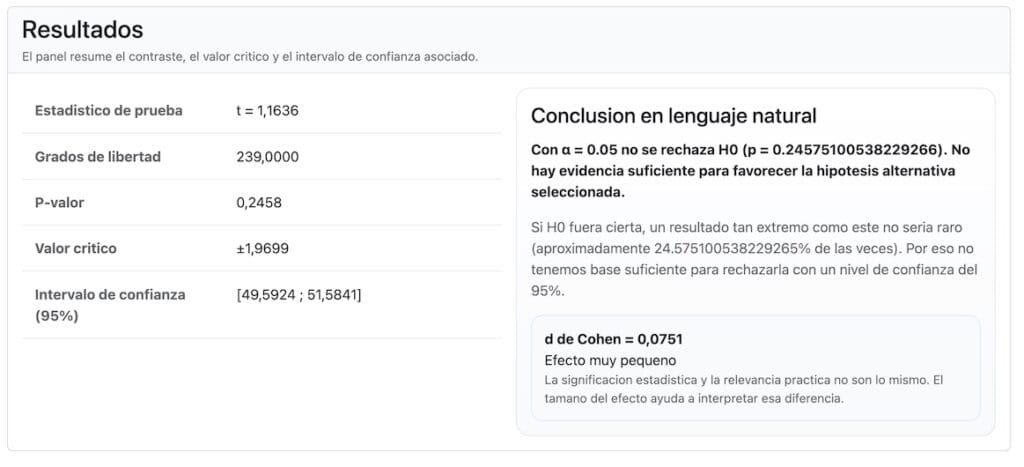
Y el gráfico de la distribución t con la zona de rechazo sombreada y el estadístico calculado marcado, visualmente inmediato si el valor cae dentro o fuera de la zona de rechazo.
Caso 2: Dos muestras independientes
Ejemplo: tienes los salarios de una muestra de empleados de dos departamentos distintos y quieres saber si la diferencia de medias es estadísticamente significativa.
En la calculadora
Selecciona T-test de dos muestras independientes. La calculadora te ofrece dos modos:
- Modo datos brutos: dos textareas, una para cada grupo. Pega los datos de cada departamento por separado.
- Modo estadísticos resumen: introduce n, media y desviación típica de cada grupo, útil si solo tienes los resultados publicados de otro estudio.
La decisión Student vs Welch
La calculadora tiene un toggle para elegir entre las dos variantes:
- Welch (por defecto, recomendado): no asume que las varianzas de los dos grupos son iguales. Es más conservador pero más seguro, funciona bien tanto si las varianzas son iguales como si no.
- Student: asume varianzas iguales. Ligeramente más potente que Welch cuando las varianzas son realmente iguales, pero puede dar resultados incorrectos si no lo son.
La regla práctica es usar Welch siempre. La calculadora muestra también el test F de igualdad de varianzas a título informativo, pero no conviene usarlo como criterio para elegir entre Student y Welch: encadenar los dos tests distorsiona el error de tipo I del contraste final, y el test F es además muy sensible a desviaciones de la normalidad. Elige Student solo si tienes razones previas y sólidas para asumir varianzas iguales.
Si los datos no son normales
Si el test de normalidad rechazó H₀ en alguno de los dos grupos, cambia al Test de Mann-Whitney en el selector. No asume normalidad y compara las distribuciones completas de ambos grupos en lugar de solo sus medias.
Caso 3: Dos muestras pareadas
Ejemplo: mides el rendimiento de 20 empleados antes y después de una formación. Cada empleado tiene dos mediciones, antes y después, y las dos observaciones de cada empleado están relacionadas entre sí.
Este caso es distinto del anterior aunque también haya dos grupos: aquí las observaciones no son independientes, la medición “antes” y la “después” del mismo empleado están correlacionadas. Tratar estas muestras como independientes sería un error que reduciría la potencia del test.
En la calculadora
Selecciona T-test de muestras pareadas. La calculadora espera dos columnas del mismo tamaño, los valores antes y los valores después para cada individuo, en el mismo orden.
Internamente el test calcula la diferencia para cada par (después − antes) y aplica un t-test de una muestra sobre esas diferencias, comprobando si su media es significativamente distinta de cero.
Si los datos no son normales
Si las diferencias (después − antes) no son normales, usa el Test de Wilcoxon de rango con signo pareado en el selector, el equivalente no paramétrico del t-test pareado.
Caso 4: Comparar proporciones
Ejemplo: quieres saber si la tasa de conversión de la versión A de tu web (12,3% de 500 usuarios) es significativamente distinta de la versión B (14,1% de 500 usuarios).
En la calculadora
Selecciona Z-test de dos proporciones. Introduce para cada grupo el número de éxitos y el número total de observaciones. La calculadora calcula automáticamente las proporciones y el estadístico Z.
Para el caso de una sola proporción comparada con un valor de referencia, por ejemplo ¿es el 12,3% significativamente distinto del 10% esperado? Selecciona Z-test de una proporción e introduce la proporción de referencia en el campo correspondiente.
Caso 5: Comparar varianzas
Ejemplo: quieres saber si la variabilidad de los tiempos de producción ha cambiado después de un cambio de proceso.
En la calculadora
Para comparar la varianza de una muestra con un valor de referencia usa el Test chi-cuadrado de varianza. Introduce n, la varianza muestral y la varianza de referencia σ₀².
Para comparar las varianzas de dos grupos independientes usa el Test F de Snedecor. La calculadora compara el cociente de varianzas con la distribución F.
Cómo interpretar siempre el resultado
Independientemente del test que uses, la calculadora muestra siempre los mismos elementos:
- El p-valor: La probabilidad de obtener un resultado tan extremo como el observado si H₀ fuera cierta. Si p < α rechazas H₀. Recuerda que p < 0,05 no significa que el efecto sea grande o importante, solo que es estadísticamente distinguible del azar.
- El intervalo de confianza: El rango de valores plausibles para el parámetro que estás estimando (diferencia de medias, proporción, etc.) con el nivel de confianza elegido. Si el intervalo no incluye el 0 (para diferencias) o el valor de referencia, el resultado es significativo, la misma conclusión que el p-valor pero expresada en las unidades del problema.
- El tamaño del efecto: La calculadora calcula automáticamente la d de Cohen para los t-tests. Un resultado puede ser estadísticamente significativo pero tener un tamaño del efecto pequeño, lo que significa que la diferencia existe pero es pequeña en términos prácticos.
- El gráfico de la distribución: La distribución del estadístico bajo H₀ con la zona de rechazo sombreada en rojo y el estadístico calculado marcado. Ver si el valor cae dentro o fuera de la zona de rechazo es inmediato visualmente.
Los errores más frecuentes al elegir un test
- Usar el t-test independiente cuando las muestras están pareadas: Si tienes mediciones antes/después del mismo individuo y las tratas como muestras independientes, pierdes potencia estadística, el test es más conservador de lo necesario y puede no detectar diferencias reales.
- Ignorar el supuesto de normalidad con muestras pequeñas: Con n < 30 la violación de la normalidad puede afectar seriamente al p-valor del t-test. Verifica siempre la normalidad con el test correspondiente antes de proceder.
- Hacer múltiples comparaciones sin corrección: Si comparas 10 grupos dos a dos, con α = 0,05 esperarías encontrar por azar aproximadamente una comparación significativa aunque no haya ninguna diferencia real. La corrección de Bonferroni (dividir α entre el número de comparaciones) es el ajuste más simple.
- Confundir significación estadística con relevancia práctica: Con muestras grandes casi cualquier diferencia es estadísticamente significativa. Revisa siempre el tamaño del efecto junto con el p-valor.
- Elegir el test después de ver los datos: Decidir el tipo de contraste (bilateral, cola derecha o cola izquierda) después de ver la dirección de la diferencia en los datos infla artificialmente el error de tipo I. El tipo de contraste debe decidirse antes de ver los resultados.
Resumen: qué test usar en cada caso
| Situación | Datos normales | Datos no normales |
|---|---|---|
| 1 muestra vs valor de referencia | T-test una muestra | Wilcoxon rango con signo |
| 2 muestras independientes | T-test Welch | Mann-Whitney |
| 2 muestras pareadas | T-test pareado | Wilcoxon pareado |
| Más de 2 grupos | ANOVA (pendiente) | Kruskal-Wallis (pendiente) |
| 1 proporción vs referencia | Z-test una proporción | — |
| 2 proporciones | Z-test dos proporciones | — |
| 1 varianza vs referencia | Chi-cuadrado | — |
| 2 varianzas | F de Snedecor | — |
Conclusiones
La calculadora de contrastes de hipótesis permite aplicar de forma fiable los tests más habituales de una y dos muestras — paramétricos y no paramétricos — sin escribir una línea de código, con la conclusión en lenguaje natural, el intervalo de confianza, el tamaño del efecto y el gráfico de la distribución en un mismo panel. La parte difícil no es calcular el test, sino elegirlo: y para eso basta con responder a las tres preguntas del árbol de decisión.
El flujo completo recomendado
- Identifica tu situación en el árbol de decisión, cuántos grupos, independientes o pareados
- Carga tus datos en estadísticos descriptivos y revisa asimetría y curtosis
- Usa el botón “Test de normalidad →” para verificar el supuesto con Shapiro-Wilk y el Q-Q
- Abre la calculadora de contrastes y transfiere los datos con el botón “← Estadísticos descriptivos”
- Selecciona el test correcto según tu situación y el resultado del test de normalidad
- Define el tipo de contraste (bilateral o unilateral) antes de ver los resultados
- Interpreta el p-valor junto con el intervalo de confianza y el tamaño del efecto, nunca el p-valor solo
Nota: La imagen de este artículo fue generada utilizando un modelo de inteligencia artificial.
Deja una respuesta