Uno de los errores más frecuentes en ciencia de datos es lanzarse a construir un modelo sin explorar primero los datos. Un modelo ajustado sobre datos mal entendidos, con outliers no detectados, variables con distribuciones inesperadas, correlaciones que no se conocían o relaciones no lineales ignoradas, puede producir resultados incorrectos aunque las métricas de validación parezcan aceptables.
El análisis exploratorio de datos (EDA, por sus siglas en inglés) es el paso previo imprescindible. No es un trámite, es donde realmente aprendes qué hay en tus datos, qué variables son prometedoras, qué problemas existen y qué decisiones de preprocesado necesitas tomar antes de modelar.
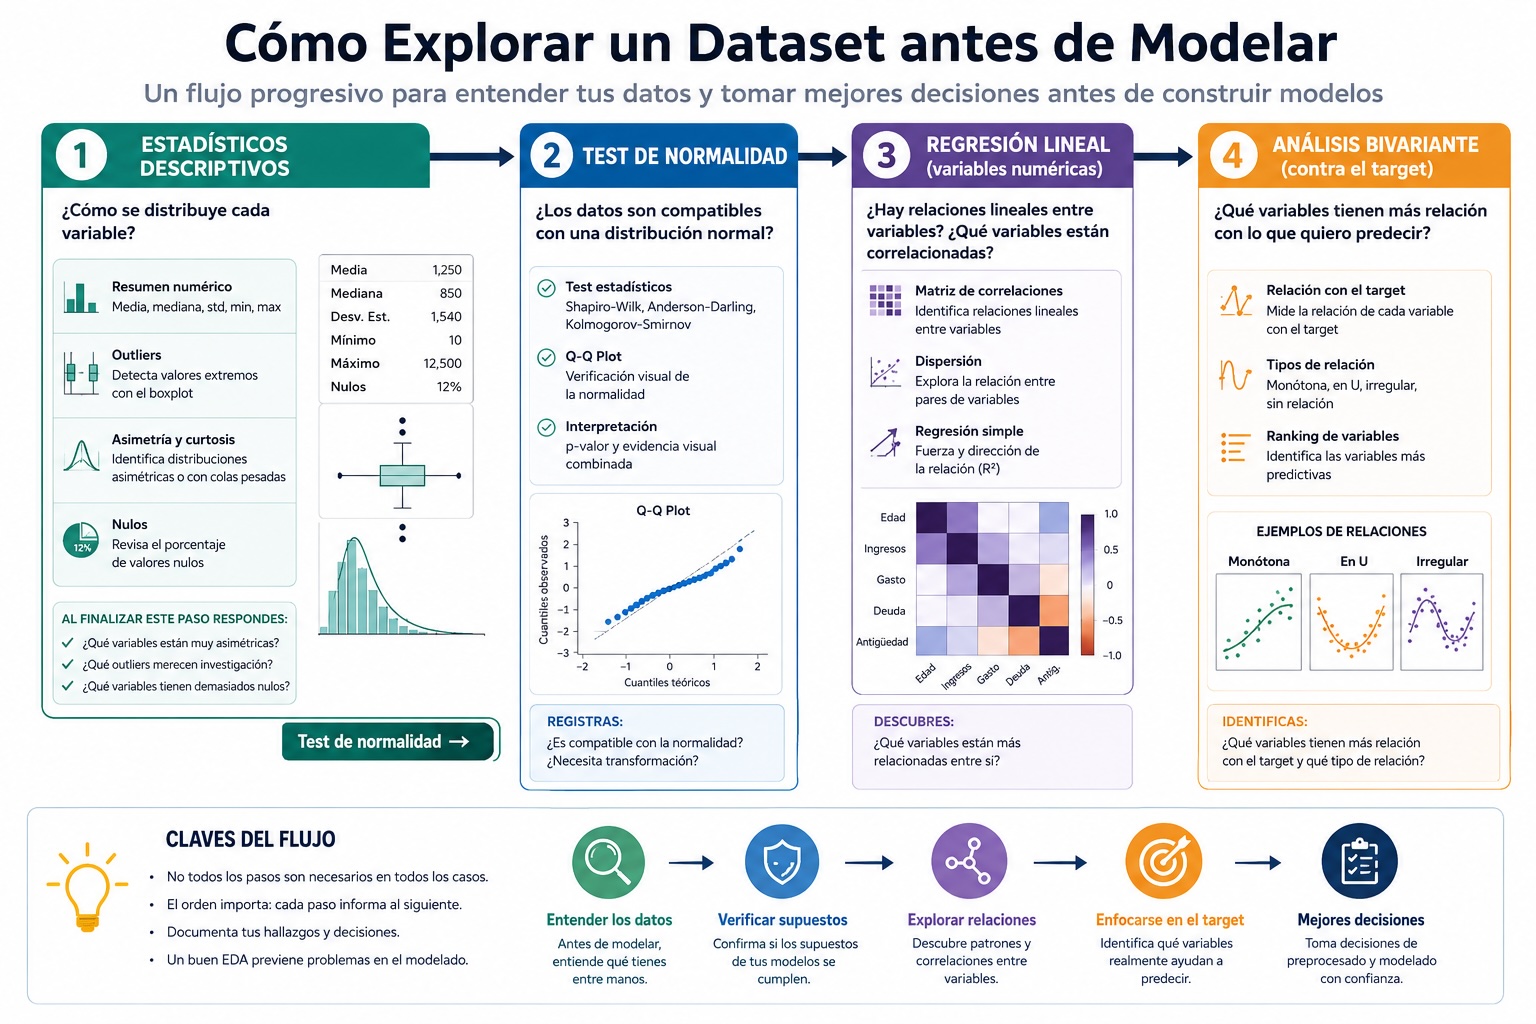
Este tutorial muestra un flujo completo de análisis exploratorio usando cuatro aplicaciones del laboratorio de Analytics Lane conectadas entre sí:
- Estadísticos descriptivos: resumen numérico y visual de cada variable
- Test de normalidad: verificación del supuesto de normalidad
- Regresión lineal: exploración de relaciones entre variables numéricas
- Análisis bivariante del constructor de scorecards: relación de cada variable con el target en problemas de clasificación
El flujo es progresivo: cada app responde una pregunta distinta y los resultados de una informan las decisiones en la siguiente.
El flujo completo de un vistazo
- Estadísticos descriptivos: ¿Cómo se distribuye cada variable? ¿Hay outliers? ¿Hay nulos? ¿Hay asimetría?
- Test de normalidad: ¿Los datos son compatibles con una distribución normal? ¿Necesito transformar alguna variable?
- Regresión lineal (variables numéricas): ¿Hay relaciones lineales entre variables? ¿Qué variables están correlacionadas entre sí?
- Análisis bivariante (si hay variable target): ¿Qué variables tienen más relación con lo que quiero predecir? ¿La relación es monótona, en U o irregular?
No todos los pasos son necesarios en todos los casos, el flujo se adapta según el tipo de problema y el tipo de datos. Pero seguirlos en orden garantiza que no te llevarás sorpresas desagradables cuando empieces a modelar.
Paso 1: Estadísticos descriptivos: el punto de partida
Abre la calculadora de estadísticos descriptivos y carga tu columna de datos, o si tienes varias variables, analiza cada una por separado.
Qué buscar
- Media vs mediana: Si la media y la mediana difieren significativamente, la distribución es asimétrica, hay una cola larga en alguna dirección. Esto es especialmente frecuente en variables financieras (ingresos, precios, importes de transacciones) donde unos pocos valores extremos elevan la media muy por encima de la mediana.
- Asimetría (skewness): Valores absolutos de asimetría superiores a 1 indican una asimetría relevante. Por encima de 2 la distribución es muy asimétrica y probablemente necesitarás una transformación (logarítmica, raíz cuadrada) si vas a usar modelos que asumen normalidad.
- Curtosis: Valores muy por encima de 3 (la curtosis de una distribución normal) indican colas pesadas, más valores extremos de lo esperado. Valores muy por debajo de 3 indican colas ligeras. Ambos casos merecen atención si el modelo que vas a usar asume normalidad.
- Mínimo, máximo y boxplot: Los outliers aparecen como puntos individuales fuera de los bigotes del boxplot. Para cada outlier que detectes hazte la pregunta: ¿es un error de medición o captura de datos, o es un valor genuino aunque extremo? Un ingreso de 2.500.000€ en un dataset de solicitudes de crédito al consumo puede ser un error o un cliente genuinamente atípico, la respuesta cambia completamente lo que harás con ese dato.
- Porcentaje de nulos: La calculadora muestra cuántos valores nulos hay y qué porcentaje representan. Por encima del 20-30% de nulos una variable se vuelve problemática, el modelo puede estar aprendiendo principalmente del patrón de nulos, no del valor de la variable.
Las tres preguntas que debes poder responder al terminar este paso
- ¿Hay variables con distribuciones muy asimétricas que podrían necesitar transformación?
- ¿Hay outliers que merecen investigación antes de modelar?
- ¿Hay variables con demasiados nulos para ser útiles?
Paso 2: Test de normalidad: ¿puedo usar métodos paramétricos?
Usa el botón “Test de normalidad →” en la calculadora de estadísticos descriptivos para transferir los datos directamente a la app de test de normalidad.
El tutorial Cómo Verificar la Normalidad de tus Datos cubre este paso en detalle. Aquí el resumen de lo que buscas en el contexto del análisis exploratorio previo al modelado:
- Variables que vas a usar como predictoras en modelos lineales: La regresión lineal no asume normalidad de las variables predictoras, solo de los residuos. Pero una variable predictora muy asimétrica puede producir residuos no normales. Si detectas asimetría severa en el paso 1, verifica la normalidad y considera una transformación logarítmica antes de incluirla en el modelo.
- Variables que quieres comparar entre grupos: Si vas a usar un t-test o ANOVA para comparar grupos antes de modelar, necesitas verificar normalidad. Con n > 30 el teorema central del límite te protege, pero con muestras pequeñas es un paso obligatorio.
- La variable objetivo en problemas de regresión: Una variable objetivo muy asimétrica (como precio de viviendas, ingresos, tiempos de respuesta) a menudo se modela mejor en escala logarítmica. El Q-Q plot te dirá visualmente si es el caso.
Lo que registras de este paso
Para cada variable analizada: ¿es compatible con la normalidad? ¿Necesita transformación? ¿Qué tipo de transformación? Esta información guía directamente las decisiones de preprocesado antes del modelado.
Paso 3: Regresión lineal: exploración de relaciones entre variables
Abre el simulador de regresión lineal para explorar las relaciones entre pares de variables numéricas.
Este uso del simulador es exploratorio, no estás ajustando un modelo final, estás entendiendo la estructura de tus datos. Para cada par de variables que te interese:
Carga los datos en el modo generador o interactivo
Si tienes dos variables numéricas y quieres ver su relación, pega los valores en el modo de datos del simulador. El gráfico de dispersión con la recta de regresión ajustada aparece de forma inmediata.
Qué buscar
- R² — fuerza de la relación lineal: El simulador muestra el R² en tiempo real. Un R² alto indica una relación lineal fuerte entre las dos variables. En el contexto exploratorio esto puede significar dos cosas distintas según las variables que estés analizando:
- Si es la relación entre una variable predictora y la variable objetivo → es una señal de que esa variable puede ser útil en el modelo
- Si es la relación entre dos variables predictoras esto implica que es una señal de multicolinealidad que puede causar problemas si ambas entran en el modelo
- La forma de la nube de puntos: Una nube que sigue una línea recta sugiere relación lineal. Una nube en forma de curva sugiere una relación no lineal que el modelo lineal no capturará bien. Una nube difusa sin estructura visible sugiere que no hay relación entre las dos variables.
- El impacto de los outliers: El simulador tiene un modo específico para ver cómo un outlier distorsiona la recta de regresión. Activa el botón “Añadir outlier” para ver cuánto cambia la recta, si cambia mucho, tienes una variable sensible a valores extremos que merece atención.
La matriz de correlaciones como guía
Si tienes muchas variables y no sabes por dónde empezar, la calculadora de estadísticos descriptivos incluye la opción de calcular la correlación de Pearson entre dos variables. Úsala para identificar los pares más correlacionados antes de explorarlos en el simulador de regresión.
Lo que registras de este paso
- ¿Qué variables tienen relaciones lineales fuertes con la variable objetivo?
- ¿Hay pares de variables predictoras muy correlacionadas entre sí (multicolinealidad)?
- ¿Hay relaciones claramente no lineales que necesitarán transformación o un modelo no lineal?
Paso 4: Análisis bivariante: la relación con el target en clasificación
Este paso es específico para problemas de clasificación, cuando tienes una variable objetivo binaria (0/1) y quieres entender qué variables predictoras tienen más relación con ella.
Abre el constructor de scorecards, carga tu dataset en el paso 1 y avanza al paso 2 — Análisis bivariante sin necesidad de completar el scorecard completo. Puedes usar este paso de forma independiente como herramienta de análisis exploratorio.
Lo que muestra el análisis bivariante
Para cada variable predictora el análisis bivariante muestra:
- La tasa de evento por cuantil (variables numéricas): Divide la variable en 10 grupos de igual tamaño y muestra qué porcentaje de los positivos (eventos) hay en cada grupo. Esto te permite ver inmediatamente la forma de la relación entre la variable y el target:
- Relación monótona: la tasa de evento sube o baja consistentemente al aumentar el valor de la variable, señal de que la variable es predictiva y la relación es estable
- Relación en U: la tasa de evento es alta en ambos extremos y baja en el centro, la variable es predictiva pero de forma no lineal
- Relación irregular: la tasa sube y baja sin patrón claro, puede indicar ruido estadístico o que la variable simplemente no es predictiva
- El IV (Information Value) preliminar: Una estimación del poder predictivo global de cada variable. Variables con IV < 0,02 probablemente no aporten al modelo. Variables con IV > 0,50 merecen revisión por posible data leakage.
- La tasa de evento por categoría (variables categóricas): Para variables categóricas muestra la tasa de evento de cada categoría, ordenada de mayor a menor. Permite identificar qué categorías tienen comportamientos distintos y cuáles podrían agruparse porque son similares.
Cómo usar este paso sin construir el scorecard completo
No necesitas completar todos los pasos del constructor para beneficiarte del análisis bivariante. Carga el dataset, configura la variable target en el paso 1, avanza al paso 2 y explora las variables que te interesen. Puedes volver al análisis sin comprometerte a construir ningún modelo.
Lo que registras de este paso
- ¿Qué variables tienen mayor IV y por tanto más poder predictivo?
- ¿Qué forma tiene la relación de cada variable con el target, monótona, en U, irregular?
- ¿Hay variables con categorías muy distintas en su tasa de evento que merezca la pena separar?
- ¿Hay alguna variable con IV sospechosamente alto que pueda ser data leakage?
Un ejemplo práctico completo
Supón que tienes un dataset de 3.000 clientes con información sociodemográfica y quieres predecir si van a contratar un producto financiero (variable target binaria).
En estadísticos descriptivos
Cargas la variable ingreso_anual y observas:
- Media: 42.300€, Mediana: 31.500€ — diferencia significativa
- Asimetría: 2,3 — muy asimétrica hacia la derecha
- Máximo: 2.400.000€ — outlier evidente en el boxplot
Decisión: la variable necesita revisión. El valor de 2.400.000€ puede ser un error de captura, merece verificación. La asimetría sugiere considerar una transformación logarítmica.
En el test de normalidad
El test de Shapiro-Wilk rechaza la normalidad con p < 0,001. El Q-Q muestra una S pronunciada con el extremo derecho muy alejado de la diagonal.
Decisión: si vas a usar esta variable en un modelo que asume normalidad, aplica transformación logarítmica. El simulador de regresión lineal te permitirá verificar si la relación con el target mejora con la transformación.
En el simulador de regresión lineal
Exploras la relación entre ingreso_anual y edad, dos de tus variables predictoras. R² = 0,04, prácticamente sin correlación entre ellas. Buena señal: no hay multicolinealidad entre estas dos variables.
Exploras la relación entre ingreso_anual y num_productos_contratados. R² = 0,31, correlación moderada. Si ambas entran en el modelo juntas puede haber multicolinealidad que dificulte la interpretación de los coeficientes.
En el análisis bivariante
Cargas el dataset completo en el constructor de scorecards (o ScoreFlow) con contratacion como variable target.
Para ingreso_anual ves una relación monótona creciente, a mayor ingreso, mayor tasa de contratación. IV = 0,18, poder predictivo medio. La relación es estable y se puede modelar bien.
Para edad ves una relación en U, los clientes muy jóvenes y los mayores de 60 tienen tasas de contratación más altas que los de mediana edad. IV = 0,09, poder predictivo débil pero con una forma interesante que merece atención en el modelado.
Para codigo_postal ves IV = 0,52, sospechosamente alto. Miles de categorías con pocas observaciones cada una. El detector automático lo marca como posible pseudo-ID.
Decisión: excluir codigo_postal de forma provisional, probablemente está memorizando el target. Incluir ingreso_anual y edad. Tener precaución con num_productos_contratados por su correlación con ingreso_anual.
Resumen del flujo
| Paso | App | Pregunta que responde | Resultado |
|---|---|---|---|
| 1 | Estadísticos descriptivos | ¿Cómo se distribuye cada variable? | Lista de variables con asimetría, outliers y nulos problemáticos |
| 2 | Test de normalidad | ¿Puedo usar métodos paramétricos? | Decisión de transformar o no cada variable |
| 3 | Regresión lineal | ¿Hay relaciones lineales entre variables? | Mapa de correlaciones y detección de multicolinealidad |
| 4 | Análisis bivariante | ¿Qué variables predicen el target? | Ranking de variables por IV y forma de la relación |
Lo que el análisis exploratorio no puede hacer
El análisis exploratorio responde preguntas sobre los datos que tienes, no sobre los datos que necesitas. Hay preguntas que solo se responden con conocimiento del negocio o del proceso que generó los datos:
- ¿Esta variable estaba disponible en el momento de la decisión o contiene información del futuro?
- ¿Este outlier es un error de captura o un cliente genuinamente atípico?
- ¿Estas dos variables aparentemente no correlacionadas tienen una relación condicional que el análisis bivariante no captura?
El análisis exploratorio es el primer paso, no el único. Los hallazgos de este flujo deben revisarse siempre con conocimiento del dominio antes de tomar decisiones de preprocesado y modelado.
Nota: La imagen de este artículo fue generada utilizando un modelo de inteligencia artificial.
Deja una respuesta