• Saltar al contenido principal
  • Skip to secondary menu
  • Saltar a la barra lateral principal
  • Saltar al pie de página
  • Inicio
  • Secciones
    • Ciencia de datos
    • Criptografía
    • Herramientas
    • Machine Learning
    • Noticias
    • Opinión
    • Productividad
    • Programación
      • JavaScript
      • Julia
      • Matlab
      • Python
      • R
  • Programación
    • JavaScript
    • Julia
    • Matlab
    • Python
    • R
  • Laboratorio
    • Estadística
      • Calculadora del Tamaño Muestral en Encuestas
      • Calculadora de estadísticos descriptivos
      • Test de normalidad
      • Calculadora de contrastes de hipotesis
      • Calculadora de tamano del efecto
      • Simulador de Regresión Lineal con Ruido
      • Visualizador de PCA
      • Visualizador de Series Temporales
      • Simulador de Regresión Logística
      • Simulador de K-Means
      • Simulador de DBSCAN
      • Detector de la Ley de Benford
      • Ajuste de Curvas
      • Calculadora de Matrices
    • Probabilidad
      • Calculadora de Probabilidad de Distribuciones
      • Calculadora de Probabilidades de Lotería
      • Simulador del Problema de Monty Hall
      • Simulador de la Estrategia Martingala
    • Finanzas
      • Calculadora de Préstamos e Hipotecas
      • Conversor TIN ↔ TAE
      • Calculadora DCA con ajuste por inflación
      • Calculadora XIRR con Flujos Irregulares
      • Simulador FIRE (Financial Independence, Retire Early)
    • Negocios
      • CLV
      • Scoring
    • Herramientas
      • Formateador / Minificador de JSON
      • Conversor CSV ↔ JSON
      • Comparador y Formateador de Texto y JSON
      • Formateador y Tester de Expresiones Regulares
      • Inspector de JWT
      • Generador y verificador de hashes
      • Codificador / Decodificador Base64 y URL
      • Conversor de bases numericas
      • Conversor de Timestamp Unix
      • Conversor de colores
      • Generador de UUIDs
    • Juegos
      • Tres en Raya
      • Nim con Q-Learning
    • Más
      • Método D’Hondt
      • Generador de Contraseñas Seguras
  • Noticias
  • Boletín
  • Contacto
  • Tienda
    • Libros
    • Equipamiento de oficina
    • Equipamiento en movilidad

Analytics Lane

Ciencia e ingeniería de datos aplicada

  • Ciencia de datos
  • Machine Learning
  • IA Generativa
  • Python
  • Pandas
  • NumPy
  • R
  • Excel

¿Cómo afecta el número de referencias en las ventas?

Marketing, Small Data

octubre 5, 2018 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 4 minutos

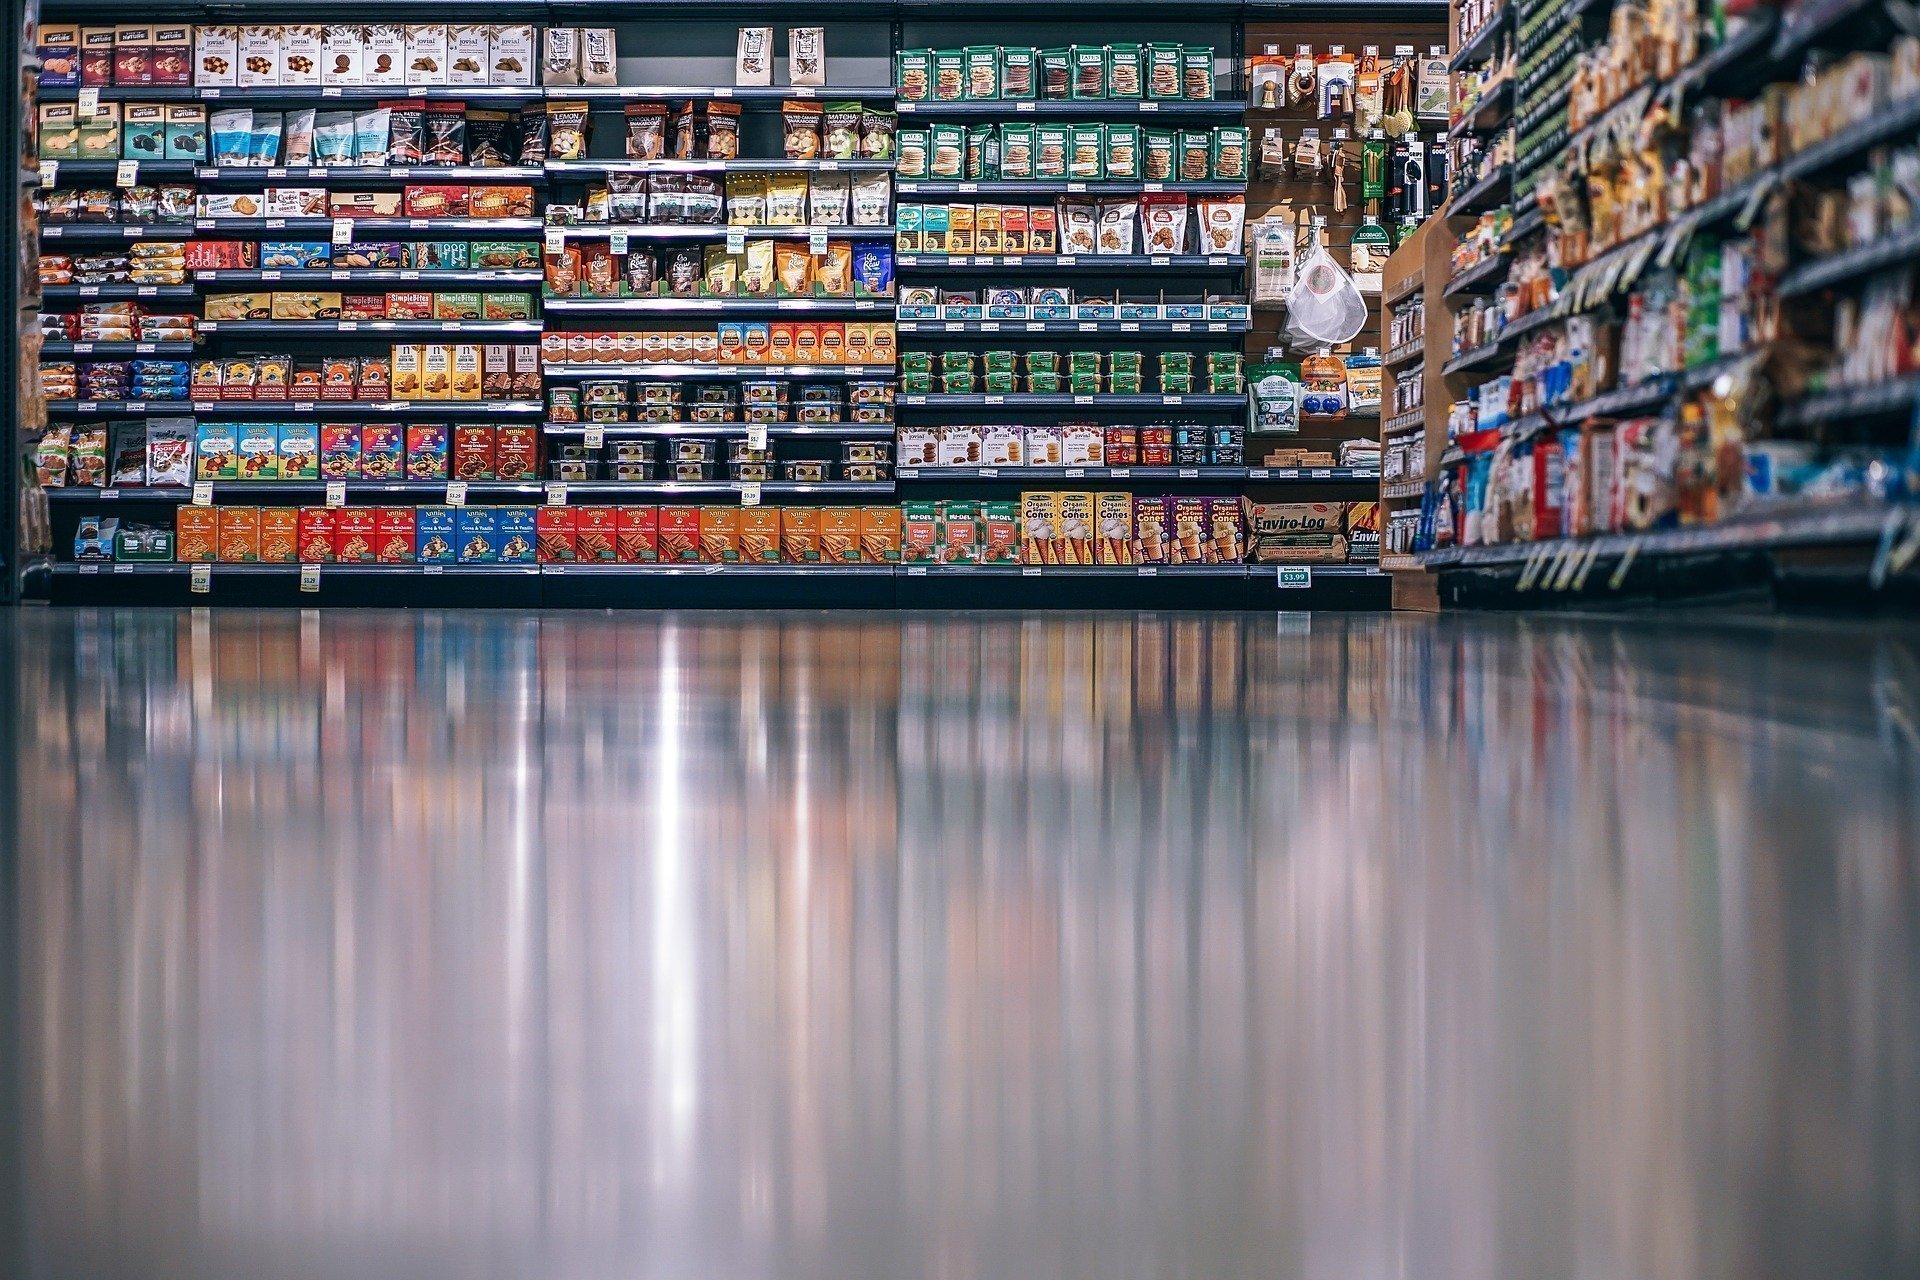
Referencias en una pasillo

Intuitivamente es fácil pensar que al aumentar el número de referencias en un catálogo las ventas han de aumentar. La justificación de esta idea tan arraigada es sencilla, al disponer de una mayor oferta es más probable satisfacer las preferencias de un número mayor de clientes. Con más clientes satisfechos es de esperar que las ventas aumentaran proporcionalmente. Pero según se puede deducir de diferentes estudios los clientes no funcionan necesariamente con esta lógica. Aumentar la oferta no tiene porqué llevar a un aumento en las venas, sino que, todo lo contrario, puede afectarles negativamente a estas.

El expositor de mermeladas
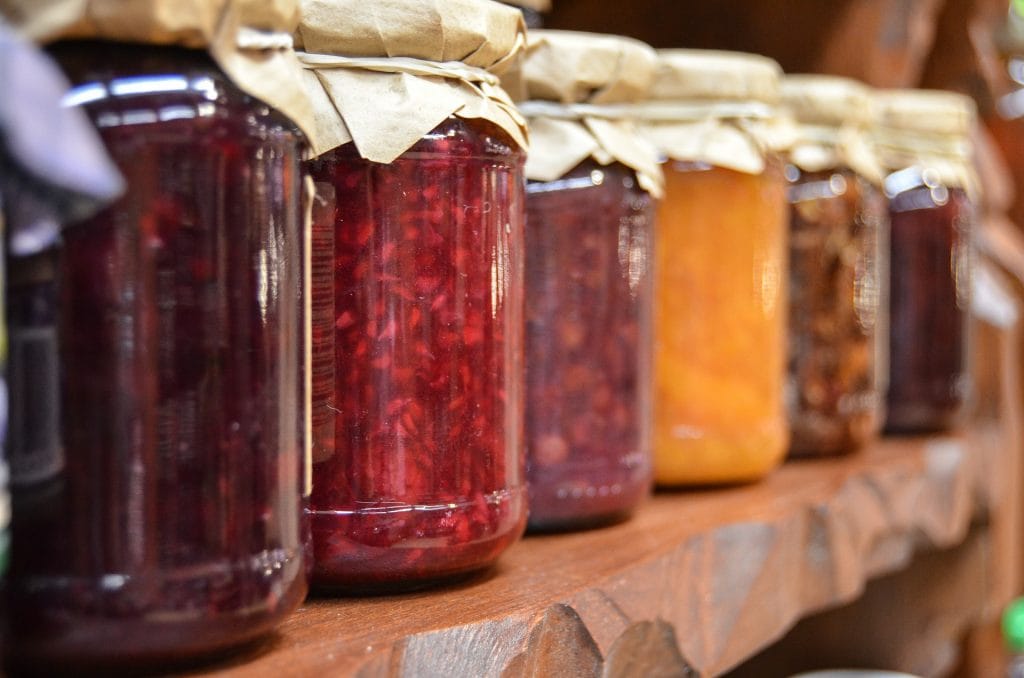
Mermeladas

A modo de ejemplo del efecto del surtido en las ventas se puede observar en el experimento del expositor de mermeladas llevado a cabo por Sheena S. Iyengar de la Universidad de Columbia. Para el experimento se situó un expositor de mermeladas en los que unas veces había 6 sabores y otras 24. En ambos casos los clientes que se acercaban al expositor recibían un vale descuento por valor de 1$ para compra de cualquier variedad del fabricante.

En una primera configuración, en la que solamente se exponen 6 sabores diferentes, el 40% (104 de 260) de los clientes que pasaron por el expositor se pararon en el. Por otro lado, al aumentar la oferta del expositor hasta los 24 sabores el número de clientes que se detuvieron aumento hasta el 60% (145 de 242). Ratificando la idea de que un mayor surtido permite atraer a más clientes.
Desbalanceo de Clases en Credit Scoring: Por Qué Usamos Ponderación en lugar de Undersampling
En Analytics Lane
Desbalanceo de Clases en Credit Scoring: Por Qué Usamos Ponderación en lugar de Undersampling

Los resultados realmente interesantes para el negocio es el número de ventas, no el de clientes. En la primera configuración (6 sabores) el porcentaje de cupones redimidos por los clientes fue de un 30% (31). Por otro lado, en la segunda configuración (24 sabores) el porcentaje se de redenciones se redujo a solamente un 4% (4). Es decir, la misma acción promocional puede ver reducida su efectividad en un factor 10 simplemente aumentado la oferta. Provocando que una campaña relativamente exitosa vea reducida su efectividad drásticamente.

El puesto de bolígrafos
Lápices de colores

En otros experimentos también se puede observar resultados similares. Por ejemplo, el puesto de bolígrafos que Avni M. Shah del Dartmouth College situó en el campus de la universidad. En este puesto los tipos de bolígrafos que se podían adquirir variaron entre 2 y 20. Para una oferta de 2 el porcentaje de estudiantes que compraron alguno fue de un 40%. Este porcentaje aumentó hasta un máximo de 90% cuando existen 10 tipos de bolígrafos diferentes. Pero, al igual que en el experimento anterior, al aumentar la oferta hasta 20 el porcentaje de alumnos que compraron se redujo a un mínimo de 30%. Es decir, el número de ventas frente a las referencias ofertadas tiene una forma de U invertida.

Estos resultados indican que aumentar la oferta por encima de un valor crítico es contraproducente. Llegando a afectar negativamente a las ventas. Como se ha visto en este experimento donde al aumentar la oferta por encima de 10 bolígrafos las ventas decayeron.

Una de las explicaciones que se ofrecen para estos resultados es la “parálisis por análisis”. Al aumentar la oferta entre las que puede escoger el cliente la decisión requiere un mayor esfuerzo, ofreciendo además más posibilidades de equivocarse, y decide retrasar esta. Lo que explica perfectamente la forma de U invertida que se ha observado en los experimentos. A medida que aumenta la oferta es se puede satisfacer a un número mayor de clientes sin que la decisión suponga un coste para ellos. Pero una vez llegado a un límite, el coste de decisión supone un freno en las ventas.

Publicidad


Conclusiones

Los experimentos que se han visto en esta entrada permiten entender cómo toman decisiones los clientes a la hora de comprar. Estos necesitan ver que sus necesidades y preferencias son satisfechas con el surtido, pero sin obligar a tomar decisiones demasiado complicadas. Obviamente el surtido óptimo se ha de analizar para cada referencia mediante experimentos como los vistos en esta entrada.

Imágenes: Pixabay (igorovsyannykov) | Pixabay (jarmoluk) | Pixabay (Free-Photos)

¿Te ha parecido de utilidad el contenido?

¡Puntúalo entre una y cinco estrellas!

Puntuación promedio 0 / 5. Votos emitidos: 0

Ya que has encontrado útil este contenido...

¡Síguenos en redes sociales!

¡Siento que este contenido no te haya sido útil!

¡Déjame mejorar este contenido!

Dime, ¿cómo puedo mejorar este contenido?

Publicaciones relacionadas

  • Desbalanceo de Clases en Credit Scoring: Por Qué Usamos Ponderación en lugar de Undersampling
  • Por Qué las Contraseñas Largas son más Seguras que las Complejas
  • Gini, KS y AUC: Cómo Medir la Calidad de un Modelo de Credit Scoring
  • Por qué migrar tus proyectos TypeScript a ES Modules en 2026
  • Curiosidad: El “bug”, la polilla y la leyenda de Grace Hopper
  • Curiosidad: Por qué la criptografía habla siempre de Alice y Bob
  • BG/BB: el modelo de CLV para compras en períodos discretos
  • Errores comunes al interpretar resultados estadísticos
  • Método del codo: interpretación correcta y limitaciones

Publicado en: Ciencia de datos Etiquetado como: Marketing, Small Data

Interacciones con los lectores

Deja una respuesta Cancelar la respuesta

Tu dirección de correo electrónico no será publicada. Los campos obligatorios están marcados con *

I accept the Terms and Conditions and the Privacy Policy

Este sitio usa Akismet para reducir el spam. Aprende cómo se procesan los datos de tus comentarios.

Barra lateral principal

Suscríbete a nuestro boletín

Suscríbete al boletín semanal para estar al día de todas las publicaciones.

Política de Privacidad

Analytics Lane en redes sociales

  • Amazon
  • Bluesky
  • Facebook
  • GitHub
  • Instagram
  • Mastodon
  • Pinterest
  • RSS
  • Telegram
  • Tumblr
  • Twitter
  • YouTube

Publicidad

Entradas recientes

Por qué migrar tus proyectos TypeScript a ES Modules en 2026

septiembre 17, 2026 Por Daniel Rodríguez

Método del codo: interpretación correcta y limitaciones

septiembre 15, 2026 Por Daniel Rodríguez

Errores comunes al interpretar resultados estadísticos

septiembre 10, 2026 Por Daniel Rodríguez

Publicidad

Es tendencia

  • Curiosidad: La Paradoja de Simpson, o por qué no siempre debes fiarte de los promedios publicado el septiembre 18, 2025 | en Ciencia de datos, Opinión
  • Entendiendo las Cópulas en estadística publicado el junio 7, 2024 | en Ciencia de datos
  • Curiosidad: Por qué la criptografía habla siempre de Alice y Bob publicado el septiembre 3, 2026 | en Criptografía, Opinión
  • Errores comunes al interpretar resultados estadísticos publicado el septiembre 10, 2026 | en Ciencia de datos
  • Gini, KS y AUC: Cómo Medir la Calidad de un Modelo de Credit Scoring publicado el agosto 18, 2026 | en Ciencia de datos

Publicidad

Lo mejor valorado

4.9 (24)

Seleccionar filas y columnas en Pandas con iloc y loc

4.6 (16)

Archivos JSON con Python: lectura y escritura

4.4 (14)

Ordenación de diccionarios en Python mediante clave o valor

4.7 (13)

Operaciones de filtrado de DataFrame con Pandas en base a los valores de las columnas

4.1 (11)

Aplicar el método D’Hondt en Excel

Comentarios recientes

  • Daniel Rodríguez en Curiosidad: La Paradoja de Simpson, o por qué no siempre debes fiarte de los promedios
  • Hatepi en Curiosidad: La Paradoja de Simpson, o por qué no siempre debes fiarte de los promedios
  • Daniel Rodríguez en Los récords con asterisco, o la épica del titular sin contexto – El bestiario de los indicadores económicos absurdos (parte 8 y final)
  • Juan en Los récords con asterisco, o la épica del titular sin contexto – El bestiario de los indicadores económicos absurdos (parte 8 y final)
  • bif en JSON en bases de datos: cuándo es buena idea y cuándo no

Publicidad


Footer

Analytics Lane

  • Acerca de Analytics Lane
  • Boletín de noticias
  • Contacto
  • Libros
  • Lo más popular
  • Noticias
  • Tienda
  • Tiendas afiliadas

Secciones

  • Ciencia de datos
  • Criptografía
  • Herramientas
  • Machine Learning
  • Opinión
  • Productividad
  • Programación
  • Reseñas

Sobre de Analytics Lane

En Analytics Lane tratamos de explicar los principales conceptos de la ciencia e ingeniería de datos con un enfoque práctico. Los principales temas tratados son ciencia de datos, ingeniería de datos, inteligencia artificial, machine learning, deep learning y criptografía. Además, también se habla de los principales lenguajes de programación y herramientas utilizadas por los científicos e ingenieros de datos.

Copyright © 2018-2026 Analytics Lane ·Términos y condiciones ·Política de Cookies ·Política de Privacidad ·Herramientas de privacidad ·Contacto