Has aplicado un t-test y obtienes p = 0,003. El resultado es estadísticamente significativo, hay evidencia sólida de que la diferencia entre los dos grupos no es producto del azar. ¿Significa eso que la diferencia es importante?
No necesariamente. Y esta distinción, entre significación estadística y relevancia práctica, es el concepto más malentendido de la estadística aplicada.
Un p-valor pequeño solo dice que la diferencia es real, que no es ruido estadístico. Pero no dice nada sobre cuán grande es esa diferencia. Con muestras suficientemente grandes, diferencias triviales e irrelevantes en la práctica producen p-valores extremadamente pequeños, y diferencias grandes e importantes pueden no alcanzar significación con muestras pequeñas.
El complemento necesario del p-valor es el tamaño del efecto, una métrica que mide la magnitud de la diferencia independientemente del tamaño muestral. Este tutorial muestra cómo calcularlo e interpretarlo usando la calculadora de tamaño del efecto del laboratorio de Analytics Lane, y cómo conectarla con la calculadora de contrastes de hipótesis para tener una visión completa.
El problema con el p-valor solo
Imagina que mides el efecto de una intervención nutricional sobre el colesterol LDL en dos grupos:
Estudio A — 20 participantes por grupo:
- Grupo control: media 145 mg/dL, desviación 25
- Grupo intervención: media 138 mg/dL, desviación 25
- Diferencia: 7 mg/dL
- T-test: p = 0,38 → no significativo
Estudio B — 2.000 participantes por grupo:
- Grupo control: media 145 mg/dL, desviación 25
- Grupo intervención: media 143 mg/dL, desviación 25
- Diferencia: 2 mg/dL
- T-test: p = 0,003 → altamente significativo
El Estudio B tiene un resultado “altamente significativo” pero la diferencia es de solo 2 mg/dL, algo clínicamente irrelevante. El Estudio A no alcanza significación pero la diferencia de 7 mg/dL podría ser clínicamente relevante. La diferencia entre los dos estudios no está en el fenómeno que estudian, está en el tamaño muestral.
El tamaño del efecto resuelve este problema: mide la magnitud de la diferencia en una escala estandarizada que no depende del tamaño muestral.
Paso 1: Obtén los estadísticos del contraste de hipótesis
El flujo recomendado empieza en la calculadora de contrastes de hipótesis. Si ya has aplicado el t-test y tienes el resultado, la calculadora ya muestra automáticamente la d de Cohen junto al p-valor, no necesitas ir a otra app.
Pero si quieres un análisis más completo del tamaño del efecto, con la visualización de las dos distribuciones superpuestas, el porcentaje de solapamiento y el Common Language Effect Size, usa el botón “Tamaño del efecto →” que transfiere los datos directamente a la calculadora especializada.
Paso 2: Introduce los datos en la calculadora de tamaño del efecto
Abre la calculadora de tamaño del efecto. Tienes dos modos de entrada:
- Modo estadísticos resumen (por defecto): Introduce para cada grupo la media, la desviación típica y el tamaño muestral. Es el modo más directo si vienes de la calculadora de contrastes o si tienes los resultados de un estudio publicado.
- Modo datos brutos: Dos textareas con los datos de cada grupo. La calculadora calcula automáticamente los estadísticos y los muestra bajo cada textarea antes de calcular el tamaño del efecto.
Usando los datos del Estudio A del ejemplo anterior:
- Grupo control: media = 145, desviación = 25, n = 20
- Grupo intervención: media = 138, desviación = 25, n = 20
Paso 3: Lee las métricas de tamaño del efecto
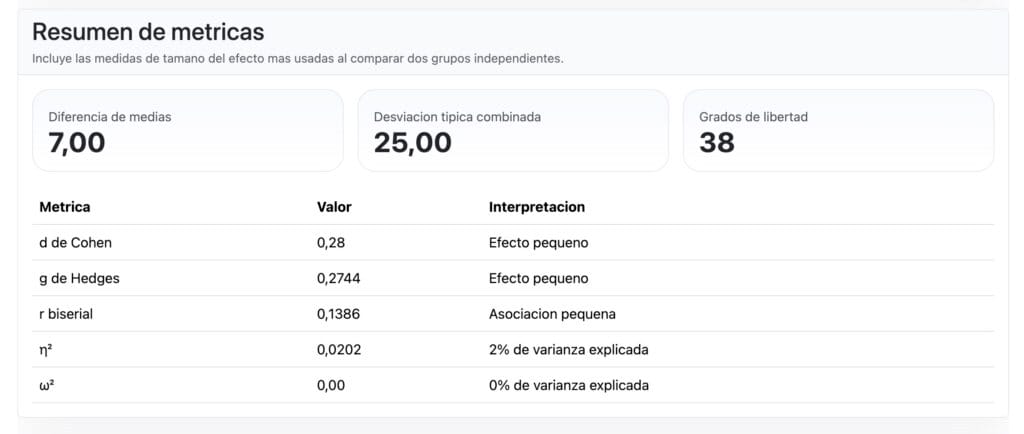
La calculadora muestra cuatro métricas principales:
- d de Cohen: La métrica más usada. Mide la diferencia entre las medias en unidades de desviación típica: d = \frac{\bar{x}<em>1 - \bar{x}_2}{s</em>{pooled}}
Con los datos del Estudio A: d = (145 − 138) / 25 = 0,28 — efecto pequeño.
Con los datos del Estudio B: d = (145 − 143) / 25 = 0,08 — efecto ínfimo.
- g de Hedges: Versión corregida de la d de Cohen para muestras pequeñas. Con n < 20 en alguno de los grupos, la d de Cohen tiene un sesgo positivo pequeño, la g de Hedges lo corrige. Con n > 30 la diferencia entre ambas es prácticamente despreciable.
- r biserial: Conversión de d a correlación. Útil para comparar con estudios que reportan correlaciones en lugar de diferencias de medias. Se calcula como r = d / \sqrt{d^2 + 4}.
- η² (eta cuadrado): Proporción de varianza explicada por la variable de grupo. Más usado en ANOVA que en t-test, pero la calculadora lo incluye para completitud.
Paso 4: La visualización que lo explica todo
La parte más valiosa de la calculadora no es la tabla de números, es la visualización de las dos distribuciones superpuestas.
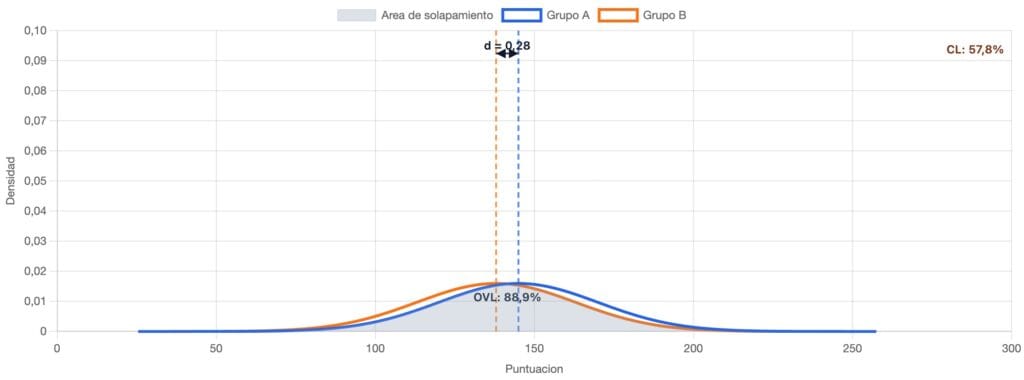
Verás dos campanas de Gauss, una para cada grupo, con el área de solapamiento sombreada. Al mover los parámetros con los sliders el solapamiento cambia en tiempo real. Este gráfico transmite de forma inmediata lo que ningún número comunica igual de bien: cuánto se confunden los dos grupos en la práctica.
Las métricas derivadas de la visualización
- Porcentaje de solapamiento (OVL): Qué proporción del área total comparten las dos distribuciones. Un solapamiento del 80% significa que los dos grupos se confunden en el 80% de los casos, la diferencia existe pero es difícil de detectar individualmente.
| d de Cohen | Solapamiento |
|---|---|
| 0,2 (pequeño) | 92% |
| 0,5 (medio) | 80% |
| 0,8 (grande) | 69% |
| 1,0 | 62% |
| 2,0 | 37% |
- CL — Common Language Effect Size: La probabilidad de que un individuo elegido al azar del grupo con mayor media supere a uno elegido al azar del otro grupo. Con d = 0,28 (Estudio A): CL ≈ 58%, un individuo del grupo control tiene colesterol más alto que uno del grupo intervención en el 58% de los casos. Con d = 0,08 (Estudio B): CL ≈ 52%, prácticamente azar.
El CL es la forma más intuitiva de comunicar el tamaño del efecto a audiencias no técnicas: “el tratamiento mejora el resultado en el 58% de los casos comparado con el control” es mucho más comprensible que “d = 0,28”.
Paso 5: Interpreta el tamaño del efecto en contexto
La convención de Cohen (pequeño/medio/grande) es un punto de partida, no una regla universal:
| d de Cohen | Interpretación convencional |
|---|---|
| < 0,2 | Ínfimo |
| 0,2 – 0,5 | Pequeño |
| 0,5 – 0,8 | Medio |
| > 0,8 | Grande |
La calculadora muestra estas convenciones pero también incluye las de Sawilowsky (2009), más granular, y las de Hattie (2009), usadas en educación. Puedes cambiar entre ellas con un selector.
Por qué el contexto importa más que la convención
Un efecto “pequeño” según Cohen puede ser muy relevante en algunos contextos y totalmente irrelevante en otros:
- Medicina: una reducción de 2 mg/dL en el colesterol LDL (d ≈ 0,08) es irrelevante clínicamente aunque sea estadísticamente significativa con 2.000 participantes. Una reducción de 20 mg/dL (d ≈ 0,80) es clínicamente importante.
- Psicología social: en experimentos conductuales con muchas variables en juego, efectos pequeños (d ≈ 0,20) son frecuentes y considerados relevantes, el comportamiento humano tiene muchas causas y capturar un 4% de la varianza puede ser un resultado sólido.
- Educación: según las convenciones de Hattie, un efecto de d > 0,40 se considera “deseado”, por debajo de ese umbral una intervención educativa no está justificando su coste.
- Industria: si una mejora en un proceso productivo tiene d = 0,15 pero se aplica a millones de unidades, el impacto acumulado puede ser enorme aunque el efecto unitario sea pequeño.
La pregunta correcta no es “¿es el efecto grande o pequeño?” sino “¿es el efecto suficientemente grande para justificar la intervención, el coste o la decisión que estoy tomando?”
Los cuatro casos combinando p-valor y tamaño del efecto
Combinando ambas métricas se obtiene una visión completa:
| P-valor | Tamaño del efecto | Interpretación | Acción |
|---|---|---|---|
| Significativo | Grande | Diferencia real e importante | Actuar con confianza |
| Significativo | Pequeño | Diferencia real pero trivial | Considerar si justifica el coste |
| No significativo | Grande | Efecto importante pero muestra insuficiente | Repetir con más participantes |
| No significativo | Pequeño | Sin diferencia real ni importante | No actuar |
El tercer caso, no significativo con efecto grande, es especialmente frecuente en estudios con muestras pequeñas. La calculadora incluye una calculadora inversa que responde a la pregunta: ¿cuántos participantes necesitaría para detectar un efecto de este tamaño con potencia 0,80 y α = 0,05? Eso es el cálculo de tamaño muestral, conectado con la calculadora de tamaño de muestra del laboratorio.
Ejemplo práctico completo
Volvamos al Estudio A de la intervención nutricional:
Datos
- Grupo control: media = 145, desviación = 25, n = 20
- Grupo intervención: media = 138, desviación = 25, n = 20
Resultados del tamaño del efecto
- d de Cohen = 0,28 (efecto pequeño-medio según Cohen)
- Solapamiento = 88,9%
- CL = 57,8%
- Interpretación completa El test no alcanza significación estadística, con solo 20 participantes por grupo no hay suficiente potencia para detectar un efecto de este tamaño. Pero el efecto en sí (d = 0,28) no es trivial, en nutrición clínica una reducción de 7 mg/dL en el colesterol LDL puede ser relevante dependiendo del perfil del paciente.
- Usando la calculadora inversa: Para detectar d = 0,28 con potencia 0,80 y α = 0,05 en un contraste bilateral se necesitan aproximadamente 202 participantes por grupo. El estudio actual con 20 por grupo tiene una potencia de solo 0,17, es decir, incluso si el efecto fuera real, solo lo detectaría el 17% de las veces.
- Conclusión práctica: No hay evidencia estadística suficiente para concluir que la intervención funciona, pero eso no significa que no funcione. El estudio es demasiado pequeño para ser conclusivo. La recomendación sería replicar con una muestra mayor antes de abandonar la intervención.
Conclusiones
Uno de los errores más frecuentes en la interpretación de resultados estadísticos es confundir significación estadística con relevancia práctica. Un estudio con una muestra muy grande puede detectar diferencias estadísticamente significativas que en la práctica son insignificantes. El tamaño del efecto responde a la pregunta que realmente importa: ¿cuán grande es la diferencia? La calculadora de tamaño del efecto es una herramienta que nos puede ayudar a responder a esas preguntas y evitar
Resumen del flujo completo
- Aplica el contraste de hipótesis en la calculadora de contrastes, obtén el p-valor
- Lee la d de Cohen que la calculadora muestra automáticamente junto al p-valor
- Si quieres el análisis completo, usa el botón “Tamaño del efecto →” para ir a la calculadora especializada
- Observa la visualización de las distribuciones superpuestas, el solapamiento y el CL comunican el efecto mejor que cualquier número
- Interpreta d en el contexto de tu campo y de la decisión que tienes que tomar — no solo según las convenciones de Cohen
- Si el resultado no es significativo pero el efecto es grande, usa la calculadora inversa para estimar cuántos participantes necesitarías
- Combina p-valor y tamaño del efecto para una conclusión completa, nunca uses uno solo
Imagen de wal_172619 en Pixabay
Deja una respuesta