• Saltar al contenido principal
  • Skip to secondary menu
  • Saltar a la barra lateral principal
  • Saltar al pie de página
  • Inicio
  • Secciones
    • Ciencia de datos
    • Criptografía
    • Herramientas
    • Machine Learning
    • Noticias
    • Opinión
    • Productividad
    • Programación
      • JavaScript
      • Julia
      • Matlab
      • Python
      • R
  • Programación
    • JavaScript
    • Julia
    • Matlab
    • Python
    • R
  • Laboratorio
    • Estadística
      • Calculadora del Tamaño Muestral en Encuestas
      • Calculadora de estadísticos descriptivos
      • Test de normalidad
      • Calculadora de contrastes de hipotesis
      • Calculadora de tamano del efecto
      • Simulador de Regresión Lineal con Ruido
      • Visualizador de PCA
      • Visualizador de Series Temporales
      • Simulador de Regresión Logística
      • Simulador de K-Means
      • Simulador de DBSCAN
      • Detector de la Ley de Benford
      • Ajuste de Curvas
      • Calculadora de Matrices
    • Probabilidad
      • Calculadora de Probabilidad de Distribuciones
      • Calculadora de Probabilidades de Lotería
      • Simulador del Problema de Monty Hall
      • Simulador de la Estrategia Martingala
    • Finanzas
      • Calculadora de Préstamos e Hipotecas
      • Conversor TIN ↔ TAE
      • Calculadora DCA con ajuste por inflación
      • Calculadora XIRR con Flujos Irregulares
      • Simulador FIRE (Financial Independence, Retire Early)
    • Negocios
      • CLV
      • Scoring
    • Herramientas
      • Formateador / Minificador de JSON
      • Conversor CSV ↔ JSON
      • Comparador y Formateador de Texto y JSON
      • Formateador y Tester de Expresiones Regulares
      • Inspector de JWT
      • Generador y verificador de hashes
      • Codificador / Decodificador Base64 y URL
      • Conversor de bases numericas
      • Conversor de Timestamp Unix
      • Conversor de colores
      • Generador de UUIDs
    • Juegos
      • Tres en Raya
      • Nim con Q-Learning
    • Más
      • Método D’Hondt
      • Generador de Contraseñas Seguras
  • Noticias
  • Boletín
  • Contacto
  • Tienda
    • Libros
    • Equipamiento de oficina
    • Equipamiento en movilidad

Analytics Lane

Ciencia e ingeniería de datos aplicada

  • Ciencia de datos
  • Machine Learning
  • IA Generativa
  • Python
  • Pandas
  • NumPy
  • R
  • Excel

Truco Jupyter: Ignorar errores en las celdas de Jupyter Notebook

Jupyter, Truco

marzo 25, 2020 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 2 minutos

En un notebook de Jupyter cuando se están ejecutando las celdas en modo y una de estas contiene un error el proceso de ejecución se para. Ignorando el resto de las celdas a partir de aquella en la que produjo el error. Generalmente este es el comportamiento que esperaríamos. Si una celda tiene un error, posiblemente el resto tampoco puedan funcionar. Pero qué pasaría si justamente lo que se desea es enseñar ese error. En este caso se pueden ignorar los errores en las celdas de Jupyter mediante el uso del uso del tag raises-exception.

Agregar tags en las celdas de Jupyter

Es posible que algunos lectores no conozcan que se pueden incluir tags en las celdas de Jupyter para modificar el comportamiento. Para lo que se tiene que ir a menú View y dentro del submenú Cell Toolbar seleccionar la opción Tags. Al hacer esto en cada una de las celdas del notebook aparecerá una opción para incluir tags.

Activando los tags en un Notebook

Ignorar errores en las celdas de Jupyter

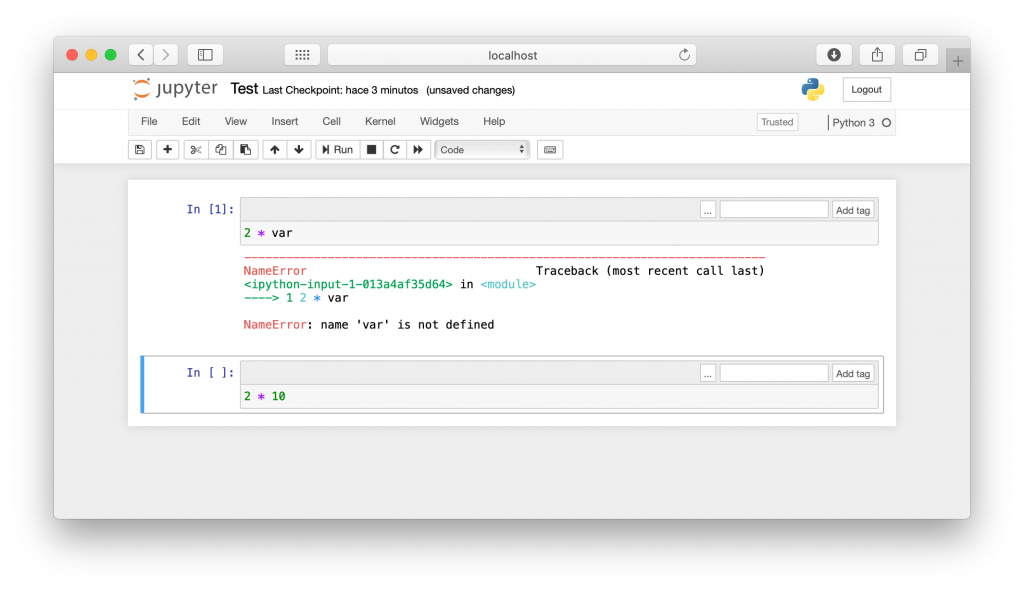
Ahora que sabemos cómo agregar un tag a una celda de un Notebook se puede ver como funciona el tag raises-exception. Si se ejecuta una celda con errores, puede verse que una vez se alcanza esta el código deja de ejecutarse. Por ejemplo, si se usa una variable o función que no ha sido definida.
Por qué migrar tus proyectos TypeScript a ES Modules en 2026
En Analytics Lane
Por qué migrar tus proyectos TypeScript a ES Modules en 2026

La celda con un error para la ejecución del código en el Notebook

Por otro lado, si a esta celda se le agrega el tag raises-exception, vermos que, a pesar del error, el código continúa ejecutándose sin problema.
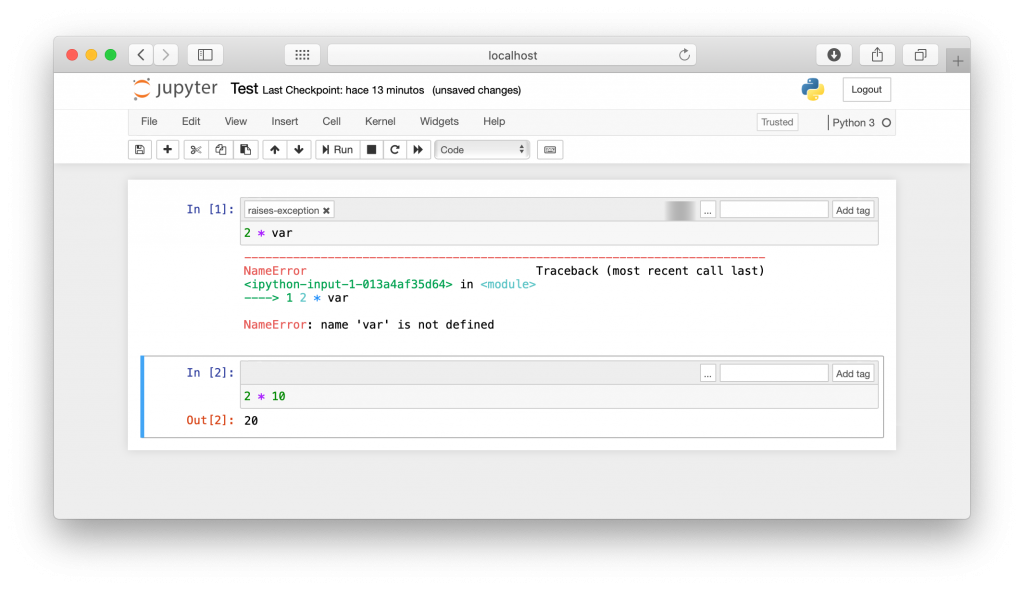
Con la etiqueta el notebook puede continuar funcionando a partir de la celda con error.

Publicidad


Conclusiones

Si por algún motivo necesitamos ignorar errores en las celdas de Jupyter Notebook se puede utilizar la etiqueta raises-exception para esto. Algo que puede ser de utilidad en algunas situaciones, como en los casos en los que deseamos enseñar cómo se produce un error en el código.

Imagen de Theodor Moise en Pixabay

¿Te ha parecido de utilidad el contenido?

¡Puntúalo entre una y cinco estrellas!

Puntuación promedio 0 / 5. Votos emitidos: 0

Ya que has encontrado útil este contenido...

¡Síguenos en redes sociales!

¡Siento que este contenido no te haya sido útil!

¡Déjame mejorar este contenido!

Dime, ¿cómo puedo mejorar este contenido?

Publicaciones relacionadas

  • Por qué migrar tus proyectos TypeScript a ES Modules en 2026
  • Actualizar expresslanets a ES Modules con tsx y Vitest
  • Migrar tslane a un paquete dual CommonJS y ESM con tsup y Vitest
  • Curiosidad: Por qué la criptografía habla siempre de Alice y Bob
  • Errores comunes al interpretar resultados estadísticos
  • Método del codo: interpretación correcta y limitaciones
  • Dashboard CLV: cuatro modelos, un mismo dataset, conclusiones muy distintas
  • Pareto/NBD: cuando el abandono silencioso cambia el CLV
  • Cómo construir tu primer scorecard paso a paso

Publicado en: Python Etiquetado como: Jupyter, Truco

Interacciones con los lectores

Deja una respuesta Cancelar la respuesta

Tu dirección de correo electrónico no será publicada. Los campos obligatorios están marcados con *

I accept the Terms and Conditions and the Privacy Policy

Este sitio usa Akismet para reducir el spam. Aprende cómo se procesan los datos de tus comentarios.

Barra lateral principal

Suscríbete a nuestro boletín

Suscríbete al boletín semanal para estar al día de todas las publicaciones.

Política de Privacidad

Analytics Lane en redes sociales

  • Amazon
  • Bluesky
  • Facebook
  • GitHub
  • Instagram
  • Mastodon
  • Pinterest
  • RSS
  • Telegram
  • Tumblr
  • Twitter
  • YouTube

Publicidad

Entradas recientes

Migrar tslane a un paquete dual CommonJS y ESM con tsup y Vitest

octubre 1, 2026 Por Daniel Rodríguez

Cómo construir tu primer scorecard paso a paso

septiembre 29, 2026 Por Daniel Rodríguez

Actualizar expresslanets a ES Modules con tsx y Vitest

septiembre 24, 2026 Por Daniel Rodríguez

Publicidad

Es tendencia

  • Hoja de cálculo para repartir los escaños en base al método D’Hont Aplicar el método D’Hondt en Excel publicado el abril 14, 2021 | en Herramientas
  • Método del codo: interpretación correcta y limitaciones publicado el septiembre 15, 2026 | en Ciencia de datos
  • Buscar en Excel con dos o más criterios publicado el septiembre 7, 2022 | en Herramientas
  • Leer y guardar archivos de Matlab en Python publicado el febrero 14, 2020 | en Matlab, Python
  • Evaluar similitudes entre señales: Cómo calcular la correlación cruzada con np.correlate() en NumPy publicado el enero 24, 2025 | en Ciencia de datos, Python

Publicidad

Lo mejor valorado

4.9 (24)

Seleccionar filas y columnas en Pandas con iloc y loc

4.6 (16)

Archivos JSON con Python: lectura y escritura

4.4 (14)

Ordenación de diccionarios en Python mediante clave o valor

4.7 (13)

Operaciones de filtrado de DataFrame con Pandas en base a los valores de las columnas

4.1 (11)

Aplicar el método D’Hondt en Excel

Comentarios recientes

  • Daniel Rodríguez en Curiosidad: La Paradoja de Simpson, o por qué no siempre debes fiarte de los promedios
  • Hatepi en Curiosidad: La Paradoja de Simpson, o por qué no siempre debes fiarte de los promedios
  • Daniel Rodríguez en Los récords con asterisco, o la épica del titular sin contexto – El bestiario de los indicadores económicos absurdos (parte 8 y final)
  • Juan en Los récords con asterisco, o la épica del titular sin contexto – El bestiario de los indicadores económicos absurdos (parte 8 y final)
  • bif en JSON en bases de datos: cuándo es buena idea y cuándo no

Publicidad


Footer

Analytics Lane

  • Acerca de Analytics Lane
  • Boletín de noticias
  • Contacto
  • Libros
  • Lo más popular
  • Noticias
  • Tienda
  • Tiendas afiliadas

Secciones

  • Ciencia de datos
  • Criptografía
  • Herramientas
  • Machine Learning
  • Opinión
  • Productividad
  • Programación
  • Reseñas

Sobre de Analytics Lane

En Analytics Lane tratamos de explicar los principales conceptos de la ciencia e ingeniería de datos con un enfoque práctico. Los principales temas tratados son ciencia de datos, ingeniería de datos, inteligencia artificial, machine learning, deep learning y criptografía. Además, también se habla de los principales lenguajes de programación y herramientas utilizadas por los científicos e ingenieros de datos.

Copyright © 2018-2026 Analytics Lane ·Términos y condiciones ·Política de Cookies ·Política de Privacidad ·Herramientas de privacidad ·Contacto