• Saltar al contenido principal
  • Skip to secondary menu
  • Saltar a la barra lateral principal
  • Saltar al pie de página
  • Inicio
  • Secciones
    • Ciencia de datos
    • Criptografía
    • Herramientas
    • Machine Learning
    • Noticias
    • Opinión
    • Productividad
    • Programación
      • JavaScript
      • Julia
      • Matlab
      • Python
      • R
  • Programación
    • JavaScript
    • Julia
    • Matlab
    • Python
    • R
  • Laboratorio
    • Estadística
      • Calculadora del Tamaño Muestral en Encuestas
      • Calculadora de estadísticos descriptivos
      • Test de normalidad
      • Calculadora de contrastes de hipotesis
      • Calculadora de tamano del efecto
      • Simulador de Regresión Lineal con Ruido
      • Visualizador de PCA
      • Visualizador de Series Temporales
      • Simulador de Regresión Logística
      • Simulador de K-Means
      • Simulador de DBSCAN
      • Detector de la Ley de Benford
      • Ajuste de Curvas
      • Calculadora de Matrices
    • Probabilidad
      • Calculadora de Probabilidad de Distribuciones
      • Calculadora de Probabilidades de Lotería
      • Simulador del Problema de Monty Hall
      • Simulador de la Estrategia Martingala
    • Finanzas
      • Calculadora de Préstamos e Hipotecas
      • Conversor TIN ↔ TAE
      • Calculadora DCA con ajuste por inflación
      • Calculadora XIRR con Flujos Irregulares
      • Simulador FIRE (Financial Independence, Retire Early)
    • Negocios
      • CLV
      • Scoring
    • Herramientas
      • Formateador / Minificador de JSON
      • Conversor CSV ↔ JSON
      • Comparador y Formateador de Texto y JSON
      • Formateador y Tester de Expresiones Regulares
      • Inspector de JWT
      • Generador y verificador de hashes
      • Codificador / Decodificador Base64 y URL
      • Conversor de bases numericas
      • Conversor de Timestamp Unix
      • Conversor de colores
      • Generador de UUIDs
    • Juegos
      • Tres en Raya
      • Nim con Q-Learning
    • Más
      • Método D’Hondt
      • Generador de Contraseñas Seguras
  • Noticias
  • Boletín
  • Contacto
  • Tienda
    • Libros
    • Equipamiento de oficina
    • Equipamiento en movilidad

Analytics Lane

Ciencia e ingeniería de datos aplicada

  • Ciencia de datos
  • Machine Learning
  • IA Generativa
  • Python
  • Pandas
  • NumPy
  • R
  • Excel

Generación de números aleatorios criptográficamente seguros en Python

febrero 27, 2023 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 2 minutos

La generación de número aleatorios criptográficamente seguros es clave para poder garantizar la seguridad y privacidad de los sistemas. Cuando los valores se obtienen de funciones que no se pueden considerar seguras, como es el caso de las librerías random o NumPy, es posible predecir los números generados. Algo que un atacante puede usar para acceder a los datos que se desean … [Leer más...] acerca de Generación de números aleatorios criptográficamente seguros en Python

Arquitecturas de almacenamiento de datos: Data Lake, Data Warehouse y Data Mart

febrero 24, 2023 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 3 minutos

Al hablar de arquitecturas de almacenamiento de datos en las organizaciones es habitual encontrarse con tres diferentes opciones: Data Lake, Data Warehouse y Data Mart. Aunque pudieran parecer diferentes nombres para una base de datos, no es así. Existen importantes diferencias conceptuales entre ellas que es importante conocer.Data LakeUn Data Lake (lago de datos) es … [Leer más...] acerca de Arquitecturas de almacenamiento de datos: Data Lake, Data Warehouse y Data Mart

Usar ChatGPT en Python
febrero 22, 2023 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 2 minutos

La semana pasada analicé cómo puede ayudar a los científicos de datos el uso de ChatGPT, comprobando que este puede implementar rápidamente análisis de datos y modelos básicos. Para lo que utilice la aplicación de chat disponible en la propia web de OpenAI. Otro método para acceder a ChatGPT es empleando el API que ofrece OpenAI, lo que permite integrar fácilmente el modelo en … [Leer más...] acerca de Usar ChatGPT en Python

Optimización de código Python con LineProfiler
febrero 20, 2023 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 3 minutos

LineProfiler es una herramienta que puede ser de gran ayuda para la optimización de código Python. Debido a que permite medir el tiempo que necesita para ejecutar cada una de las líneas de un programa. Pudiendo identificar de esta manera aquellas que requieren más tiempos. Así, se pueden focalizar los esfuerzos en mejorar el rendimiento solamente de aquellas partes de código … [Leer más...] acerca de Optimización de código Python con LineProfiler

Interpretación de las predicciones de los árboles de regresión y Random Forest
febrero 17, 2023 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 3 minutos

Una de las ventajas de usar árboles de regresión es su interpretabilidad. Cuando se crea un modelo a partir de un árbol de regresión no solamente se puede obtener una predicción para cada uno de los registros, sino que también es posible saber cuánto afecta cada una de las características usadas al resultado final. Aunque esto no se puede hacer directamente en Scikit-learn. … [Leer más...] acerca de Interpretación de las predicciones de los árboles de regresión y Random Forest

Implementar modelos de aprendizaje automático con ChatGPT
febrero 15, 2023 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 6 minutos

ChatGPT es un modelo de lenguaje desarrollado por OpenAI que puede producir respuestas a las cuestiones que se le plantean de forma similar a como lo haría un humano. Con capacidad de comprender el contexto de las preguntas y seguir una conversación. Por lo que es capaz ampliar o corregir las respuestas generadas anteriormente dentro de una conversación en base a las cuestiones … [Leer más...] acerca de Implementar modelos de aprendizaje automático con ChatGPT

Reemplaza loc e iloc para mejorar el rendimiento en bucles
febrero 13, 2023 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 4 minutos

Dos de los métodos más utilizados para acceder a los elementos de una Serie o un DataFrame en Pandas son loc e iloc. Algo que se debe a su gran flexibilidad, permite seleccionar elementos o subconjuntos usando tanto los nombres de las etiquetas (loc) como la posición (iloc) de forma intuitiva. Aunque, en algunos casos, pueden ofrecer problemas de rendimiento. Por ejemplo, en … [Leer más...] acerca de Reemplaza loc e iloc para mejorar el rendimiento en bucles

Reducir el tamaño en SQL Server de una base de datos
febrero 10, 2023 Por Daniel Rodríguez 2 comentarios
Tiempo de lectura: 3 minutos

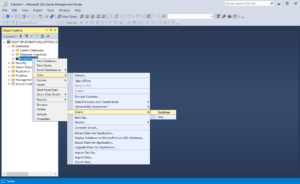
Seleccionar la opción para compactar la base de datos en Microsoft SQL Server Manager Studio

Las bases de datos generalmente suelen ocupar mucho espacio en el disco. Aunque no siempre todo contiene datos. Al eliminar registros en una base de datos, generalmente el tamaño de los archivos no se reduce porque estos se marcan como eliminados pero el espacio no se elimina del disco. A medida que pase el tiempo, esto puede suponer una cantidad importante de espacio en el … [Leer más...] acerca de Reducir el tamaño en SQL Server de una base de datos

Evaluación del uso de Tabnine (herramienta de autocompletado de código) en la creación de modelos de aprendizaje automático
febrero 8, 2023 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 4 minutos

El autocompletado de código es una funcionalidad que se encuentra en la mayoría de los editores de código modernos. Lo que evita muchos errores y consultas a la documentación. Recientemente han aparecido en el mercado unas soluciones basadas en inteligencia artificial que prometen un paso más allá; no solo completan el código, sino que puede escribir éste de forma automática en … [Leer más...] acerca de Evaluación del uso de Tabnine (herramienta de autocompletado de código) en la creación de modelos de aprendizaje automático

Diferencias entre loc e iloc en Pandas
febrero 6, 2023 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 3 minutos

pandas

La selección de elementos en los DataFrames de Pandas se puede realizar mediante dos métodos: loc e iloc. Aunque, en algunos casos, pueden parecer intercambiables, no es así. Existen importantes diferencias entre loc e iloc. Conocer estas permite seleccionar la opción más adecuada en cada caso.Principal diferencia entre loc e ilocLa principal diferencia que existe entre … [Leer más...] acerca de Diferencias entre loc e iloc en Pandas

AirTag: los dispositivos de localización Bluetooth de Apple
febrero 3, 2023 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 4 minutos

Los dispositivos de localización Bluetooth no son un concepto nuevo, ya existían dispositivos comerciales desde hace una década. De hecho, ya hablé de este tipo de gadgets en el blog hace tres años. Pequeños dispositivos, algo más grandes que una moneda, que se pueden llevar junto a objetos como llaves o mochilas para facilitar su localización en caso de extravío. A través de … [Leer más...] acerca de AirTag: los dispositivos de localización Bluetooth de Apple

Creación de archivos Zip en Node

febrero 1, 2023 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 4 minutos

Los archivos Zip son posiblemente el formato de compresión de datos sin pérdida más utilizado. Convirtiéndolo en un estándar para comprimir cualquier tipo de documento, pudiendo de esta forma tanto almacenar como enviar este en un archivo mucho más pequeño que el original. Lo que permite ahorrar espacio de almacenamiento o ancho de banda. Veamos cómo se pueden crear los … [Leer más...] acerca de Creación de archivos Zip en Node

  • « Ir a la página anterior
  • Página 1
  • Páginas intermedias omitidas …
  • Página 43
  • Página 44
  • Página 45
  • Página 46
  • Página 47
  • Páginas intermedias omitidas …
  • Página 106
  • Ir a la página siguiente »

Barra lateral principal

Suscríbete a nuestro boletín

Suscríbete al boletín semanal para estar al día de todas las publicaciones.

Política de Privacidad

Analytics Lane en redes sociales

  • Amazon
  • Bluesky
  • Facebook
  • GitHub
  • Instagram
  • Mastodon
  • Pinterest
  • RSS
  • Telegram
  • Tumblr
  • Twitter
  • YouTube

Publicidad

Entradas recientes

Curiosidad: “Wi-Fi” no significa “Wireless Fidelity”

noviembre 12, 2026 Por Daniel Rodríguez

Shallow copy vs Deep copy en Python: la mutación inesperada

noviembre 10, 2026 Por Daniel Rodríguez

Cómo Saber si una Diferencia Significativa es Importante

noviembre 5, 2026 Por Daniel Rodríguez

Publicidad

Es tendencia

  • La tabla de la web finalmente importada en Excel Importar tablas desde la web en Excel publicado el octubre 21, 2020 | en Herramientas
  • Gráficos de barras en Matplotlib publicado el julio 5, 2022 | en Python
  • Seleccionar filas y columnas en Pandas con iloc y loc publicado el junio 21, 2019 | en Python
  • Codificación JSON Archivos JSON con Python: lectura y escritura publicado el julio 16, 2018 | en Python
  • ¿Qué es la estadística y por qué todos deberíamos comprenderla? publicado el noviembre 22, 2024 | en Opinión

Publicidad

Lo mejor valorado

4.9 (24)

Seleccionar filas y columnas en Pandas con iloc y loc

4.6 (16)

Archivos JSON con Python: lectura y escritura

4.4 (14)

Ordenación de diccionarios en Python mediante clave o valor

4.7 (13)

Operaciones de filtrado de DataFrame con Pandas en base a los valores de las columnas

4.1 (11)

Aplicar el método D’Hondt en Excel

Comentarios recientes

  • Daniel Rodríguez en Curiosidad: La Paradoja de Simpson, o por qué no siempre debes fiarte de los promedios
  • Hatepi en Curiosidad: La Paradoja de Simpson, o por qué no siempre debes fiarte de los promedios
  • Daniel Rodríguez en Los récords con asterisco, o la épica del titular sin contexto – El bestiario de los indicadores económicos absurdos (parte 8 y final)
  • Juan en Los récords con asterisco, o la épica del titular sin contexto – El bestiario de los indicadores económicos absurdos (parte 8 y final)
  • bif en JSON en bases de datos: cuándo es buena idea y cuándo no

Publicidad


Footer

Analytics Lane

  • Acerca de Analytics Lane
  • Boletín de noticias
  • Contacto
  • Libros
  • Lo más popular
  • Noticias
  • Tienda
  • Tiendas afiliadas

Secciones

  • Ciencia de datos
  • Criptografía
  • Herramientas
  • Machine Learning
  • Opinión
  • Productividad
  • Programación
  • Reseñas

Sobre de Analytics Lane

En Analytics Lane tratamos de explicar los principales conceptos de la ciencia e ingeniería de datos con un enfoque práctico. Los principales temas tratados son ciencia de datos, ingeniería de datos, inteligencia artificial, machine learning, deep learning y criptografía. Además, también se habla de los principales lenguajes de programación y herramientas utilizadas por los científicos e ingenieros de datos.

Copyright © 2018-2026 Analytics Lane ·Términos y condiciones ·Política de Cookies ·Política de Privacidad ·Herramientas de privacidad ·Contacto