
Uno de los métodos numéricos más sencillos para obtener las raíces de una función es el método de la secante. Existe una modificación de este método en el que se usa una aproximación cuadrática en lugar de una línea llamado método de Muller. Este cambio permite una convergencia más rápida hacia el resultado y una mayor estabilidad.El método de MullerAl igual que el … [Leer más...] acerca de El método de Muller e implementación en Python
Números aleatorios criptográficamente seguros en Node
La creación de número criptográficamente es esencial para poder garantizar la seguridad de los datos y comunicaciones frente a posibles ataques. Los números criptográficamente seguros son aquellos que se generan de tal manera que son imprescindibles para cualquier persona que no tenga acceso al sistema. Cuando no es así un atacante los podría adivinar. En JavaScript, la función … [Leer más...] acerca de Números aleatorios criptográficamente seguros en Node
Gráficos de Hexbin: alternativa a los gráficos de dispersión en Python
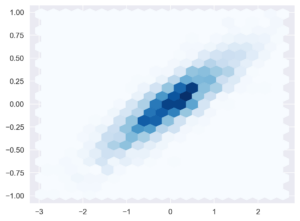
Los gráficos de dispersión son uno de los más utilizados para representar cómo se distribuyen los valores de un conjunto de datos en un plano. Son fáciles de crear y sencillos de interpretar. Aunque, cuando el conjunto de datos cuenta con centenas de registros, los gráficos de dispersión pueden ser demasiado densos para interpretarlos. En esta situación una alternativa es … [Leer más...] acerca de Gráficos de Hexbin: alternativa a los gráficos de dispersión en Python
El método de Steffensen e implementación en Python

El método de Steffensen es un algoritmo para encontrar las raíces de una función propuesto por el matemático danés Johan Frederik Steffensen en 1924. Siendo un método que suele converger rápidamente a la solución. Además, a diferencia del método de Newton, no es necesario disponer de la función deriva, por lo que su implementación es más sencilla.El método de … [Leer más...] acerca de El método de Steffensen e implementación en Python
Modelos de aprendizaje automático con ChatGPT en español
Hace unas semanas publiqué una entrada en la que evalúe las posibilidades que tiene ChatGPT para la creación de modelos de aprendizaje automático. Comprobando que es una herramienta que puede servir de ayuda para aquellos que comienzan. En aquella ocasión trabajé con la herramienta en inglés, debido a que este es el idioma en el que suelen entrenarse los modelos y, por lo … [Leer más...] acerca de Modelos de aprendizaje automático con ChatGPT en español
Uso del método de Pandas diff() con cadenas de texto
El método diff() de Pandas permite obtener la diferencia entre los valores de un registro y el siguiente para todos una serie. Aunque solamente funciona cuando las series contienen valores de tipo numérico o fecha, no cadenas de texto. Si se necesita saber cuándo los valores de una serie con texto cambian de un registro a al siguiente, será necesario crear un método equivalente … [Leer más...] acerca de Uso del método de Pandas diff() con cadenas de texto
El método de las aproximaciones sucesivas e implementación en Python

Entre los métodos numéricos para obtener la raíz de una función más sencillos de implementar se encuentran el método de las aproximaciones sucesivas. El cual se basa en el uso de una función que aproxima la solución para obtener esta de una forma iterativa. Siendo una alternativa a otros métodos numéricos como pueden ser los métodos de la bisección, la secante o el de … [Leer más...] acerca de El método de las aproximaciones sucesivas e implementación en Python
Incluir fórmulas en la documentación de TSDoc
Posiblemente la forma más sencilla para crear la documentación de una librería escrita en TypeScript es usar TSDoc. Un formato estándar para escribir los comentarios a partir del cual se puede extraer información. Así, simplemente escribiendo los comentarios de las funciones, clases y métodos se crea y actualiza la documentación del proyecto. En el caso de trabajar con … [Leer más...] acerca de Incluir fórmulas en la documentación de TSDoc
Optimizar código en Jupyter con el decorador @profile
En una publicación anterior se vio como se puede optimizar el código Python usando LineProfiler, una librería con la se puede analizar el tiempo que necesita cada línea de un programa para finalizar. Lo que permite centrar las mejoras solamente en aquellas áreas donde el código es lento. En aquella ocasión se vio como en un archivo de Python la forma más sencilla de usar esta … [Leer más...] acerca de Optimizar código en Jupyter con el decorador @profile
Eliminar características colineales con la matriz de correlación
En aprendizaje automático el uso de características colineales para el entrenamiento es un problema que puede afectar a la calidad de los modelos, especialmente en los lineales. Por lo que es necesario identificarlas y eliminarlas. Una de las razones para hacer esto es usar la matriz de correlación dado que la multicolinealidad se produce cuando dos o más características están … [Leer más...] acerca de Eliminar características colineales con la matriz de correlación
GUI para Stable Diffusion
Stable Diffusion en un modelo de aprendizaje automático de código abierto entrenado para generar imágenes a partir de una cadena de texto (prompt). Aunque se puede instalar desde un repositorio de GitHub, puede ser un poco complicado para la mayoría de los usuarios. Afortunadamente para aquellos que quieran una forma más sencilla existe DiffusionBee una GUI para Stable … [Leer más...] acerca de GUI para Stable Diffusion
Traducción al castellano de “Python for Data Analysis” de Wes McKinney
El libro "Python for Data Analysis" de Wes McKinney, una de las mejores referencias para iniciarse en el uso de la librería Pandas, ya se encuentra disponible en castellano con el título “Python para análisis de datos”. Un libro que ya había recomendado anteriormente en su versión en inglés.“Python para análisis de datos” es un libro imprescindible para cualquier persona … [Leer más...] acerca de Traducción al castellano de “Python for Data Analysis” de Wes McKinney