Mito es una interfaz para el análisis de datos basaos en JupyterLab con un funcionamiento similar al de las hojas de cálculo. Permitiendo llevar a cabo complejos análisis en pocos segundos, creando además de forma automática código Python con el que repetir las operaciones en cualquier conjunto de datos similar. Lo que permite crear análisis de datos en Python al estilo de … [Leer más...] acerca de Análisis de datos en Python al estilo Excel con Mito
Reflexionar en GTD
En tres publicaciones anteriores se han mostrado los pasos necesarios para poner en marcha un sistema de productividad basado en GTD. El cual comienza con la captura de todas aquellas cosas que son relevantes o pueden ser de interés para nosotros. Una vez capturadas estas es necesario clarificar cada una de ellas para saber qué son concretamente e identificar si requieren … [Leer más...] acerca de Reflexionar en GTD
Lectura y escritura de archivos Apache Arrow o Feather en R
En entradas recientes hemos hablado de las ventajas que ofrecen los archivos Apache Arrow o Feather frente a los tradicionales CSV. No solo ocupan menos espacio en disco, sino que los procesos de lectura y escritura son varios órdenes de magnitud más rápidos. Siendo ambas son grandes ventajas cuando se trabaja con conjunto de datos de gran tamaño. La única desventaja podría ser … [Leer más...] acerca de Lectura y escritura de archivos Apache Arrow o Feather en R
Pandas: Renombrar columnas en Pandas
Los DataFrame de Pandas ofrecen la posibilidad de almacenar datos con indexación, tanto para filas como para columnas. Índices que puede ser necesario cambiar. Para ello se puede usar el método set_axis(), aunque puede ser poco productivo cuando solamente se quiere cambiar unos pocos índices. En estos caso se puede usar el método rename(). Veamos a continuación la forma de … [Leer más...] acerca de Pandas: Renombrar columnas en Pandas
Organizar en GTD
Según GTD una vez aclarado el contenido de las bandejas de entrada es necesario organizar este en diferentes contenedores. Lo que se lleva a cabo en la tercera fase de la metodología: organizar. La tarea de organizar en GTD se realiza inmediatamente después de clarificar, siendo la separación entre estas dos fases más bien conceptual que operativa.Esta entrada forma parte … [Leer más...] acerca de Organizar en GTD
Función de interpolación lineal en Excel sin VBA
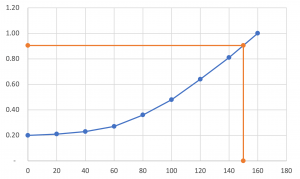
Microsoft Excel no cuenta actualmente con una función que nos permita obtener una interpolación lineal de una serie de datos. De modo que, para estimar el valor que tomaría una serie entre dos puntos es necesario hacerlo mediante las funciones de Excel o creando un macro. En el siguiente video se puede ver cómo crear una función para obtener la interpolación lineal en Excel sin … [Leer más...] acerca de Función de interpolación lineal en Excel sin VBA
Pandas: Cambiar el tipo de columnas en un DataFrame
Al crear un nuevo DataFrame en Pandas, si no se indica de forma explícita, el constructor le asignará a cada una de las series el tipo de dato que considere más adecuado. Pudiendo ser diferente al que necesitamos. Especialmente cuando en los datos originales se combinan valores numéricos con cadenas de texto. Para solucionar estos problema y cambiar el tipo de columnas en un … [Leer más...] acerca de Pandas: Cambiar el tipo de columnas en un DataFrame
Clarificar en GTD
En la segunda fase de la metodología GTD, clarificar o procesar, se define qué es cada una de las cosas capturadas anteriormente y almacenadas en las bandejas de entradas. Aclarando si estas cosas con tareas, proyecto, información relevante o basura. El proceso de clarificar en GTD se realiza respondiendo a una serie de preguntas con las que se puede etiquetar las cosas de una … [Leer más...] acerca de Clarificar en GTD
Importar archivos Apache Arrow o Feather en Julia
Recientemente hemos visto las ventajas que ofrece el uso del formato de archivo Feather frente a CSV en Python. En primer lugar, el tamaño de los archivos resultantes es mucho más pequeño, en torno a un tercio. Además, el tiempo necesario para guardar y cargar los datos es varios órdenes de magnitud, lo que significa pasar de segundos a décimas de segundos. Siendo ambos … [Leer más...] acerca de Importar archivos Apache Arrow o Feather en Julia
Almacenar los datos de forma eficiente con Feather en Python
El formato de archivo CSV es uno de los más populares para el intercambio de datos. Lo que es debido a estar basado en un archivo de texto plano, por lo que puede ser interpretado prácticamente en cualquier sistema por cualquier programa. Aunque esto también es un problema, ya que un archivo CSV ocupa demasiado espacio y los procesos de lectura y escritura son lentos. Para … [Leer más...] acerca de Almacenar los datos de forma eficiente con Feather en Python
Capturar en GTD
Capturar o recopilar es la primera de las cinco fases de la metodología GTD. La cual consiste en guardar en un contenedor que sea de fácil acceso todas aquellas cosas que son relevantes para nosotros. Cosas que no tienen porqué traducirse posteriormente en tareas. Tal como se entienden capturar en GTD este deber ser un proceso completamente mecánico, únicamente hay que guardar … [Leer más...] acerca de Capturar en GTD
Eliminar los kernels en Jupyter

A medida que trabajamos con Jupyter Notebook es posible que instalemos múltiples kernels. Algo que es normal, ya que nos permite trabajar con diferentes versiones de Python, Julia o R sin afectar al entorno de producción. Aunque tiene un problema, una vez desinstalado el entorno este no se borra de la configuración de Jupyter, por lo que será posible seleccionar este, aunque no … [Leer más...] acerca de Eliminar los kernels en Jupyter