
El pasado sábado publiqué una entrada, básicamente en tono de humor, en el que intentaba predecir mediante el uso de series temporales el resultado del Sorteo Extraordinario de Navidad de la Lotería Nacional. Un sorteo de lotería muy popular en España que para muchos supone el comienzo de las fiestas navideñas. La idea de usar una serie temporal para predecir no tenía sentido, … [Leer más...] acerca de El gordo del sorteo de Navidad no ha sido el 72850
Archivos Parquet en Julia
En una publicación reciente se ha visto las ventajas que ofrece el uso de archivos Parquet frente a CSV o Feather en Pandas. Consiguiendo guardar un conjunto de datos aleatorios en un archivo un 10% más pequeño que CSV con compresión hasta 100 veces más rápido. Algo que, en algunos puntos, mejora el rendimiento de Feather. Veamos como se puede trabajar con archivos Parquet en … [Leer más...] acerca de Archivos Parquet en Julia
Uso de Parquet para guardar los conjuntos de datos de forma eficiente en Pandas
Los formatos de archivo para el intercambio de datos más populares actualmente son CSV y Microsoft Excel. Resultando ambos poco eficientes a la hora trabajar con grandes conjuntos de datos. CSV es un formato basado en archivos de texto plano, lo que permite su edición con cualquier editor de texto, sin la necesidad de emplear un programa específico. Aunque esto también se … [Leer más...] acerca de Uso de Parquet para guardar los conjuntos de datos de forma eficiente en Pandas
Predecir el premio en la Lotería de Navidad con series temporales
El Sorteo Extraordinario de Navidad de la Lotería Nacional es una tradición que se celebra en España desde hace más de dos siglos. Un sorteo que se celebra todos los años el 22 de diciembre y, para mucha gente, representa el comienzo de las celebraciones de Navidad. Al acercarse las fechas de Navidad, un amigo me preguntó si sería posible predecir el premio en la Lotería de … [Leer más...] acerca de Predecir el premio en la Lotería de Navidad con series temporales
Regresión de Vectores de Soporte (SVR, Support Vector Regression)
La Regresión de Vectores de Soporte (SVR, del inglés Support Vector Regression) es un algoritmo de regresión basado en los mismos algoritmos que usan las Máquinas de Vectores de Soporte (SVM, del inglés Support Vector Machines) para la creación de modelos de clasificación. Aunque existen algunas diferencias debido a que la salida de una regresión es un valor real y no una … [Leer más...] acerca de Regresión de Vectores de Soporte (SVR, Support Vector Regression)
Obtener el listado de las variables en Julia

Cuando se está trabajando en una sesión de Julia puede ser necesario conocer cuales son las variables que están cargadas en memoria. Pudiendo localizar de esta manera aquellas que ya no utilizan. Para conseguir el listado de las variables en Julia contamos con la función varinfo().Obtener el listado de las variables en JuliaLa función con la que se puede obtener … [Leer más...] acerca de Obtener el listado de las variables en Julia
Creación de tablas resumen en Python con Sidetable
Sidetable es un complemento para Pandas con el que es posible crear fácilmente tablas resumen en Python de los conjuntos de datos. Lo que consigue mediante la combinación de funciones de tabulación cruzada y recuento de datos, simplificando muchos análisis habituales.Instalación y conjunto de datos de ejemploEl método más sencillo para instalar Sidetable en Python es … [Leer más...] acerca de Creación de tablas resumen en Python con Sidetable
Herramienta para auditar los paquetes de Phython
A principios de este mes se ha publicado en PyPi una nueva herramienta (pip-audit) para auditar los paquetes de Python en búsqueda de vulnerabilidades conocidas. Un proyecto que se ha desarrollado por Trail of Bits con el apoyo de Google. Una buena noticia después de que se hubiese publicado recientemente la existencia de varios paquetes con código maliciosos en PyPI [junio … [Leer más...] acerca de Herramienta para auditar los paquetes de Phython
¿Siguen las visitas a Analytics Lane la ley de la potencia?
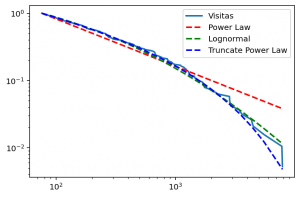
Hace un par de años, en los primeros días del blog, intenté comprobar si las visitas a Analytics Lane seguían la ley de la potencia. Sin obtener en aquel momento un resultado claro. La ley de la potencia es una relación entre magnitudes que se puede observar en múltiples fenómenos de carácter físico, biológico o debido a la actividad humana. Ahora, una vez han aumentado el … [Leer más...] acerca de ¿Siguen las visitas a Analytics Lane la ley de la potencia?
Implementación de GTD con Things 3

Aunque la metodología GTD se puede implementar con lápiz y papel contar con un gestor de tareas diseñado para la misma puede ser de gran ayuda. Uno de los más populares para los usuarios de Mac es Things. Aunque no es 100% fiel a la metodología, como prácticamente ninguna aplicación, es relativamente fácil adaptada a la misma.En el siguiente video se muestra como usar esta … [Leer más...] acerca de Implementación de GTD con Things 3
Visualización de valores faltantes con Missingno
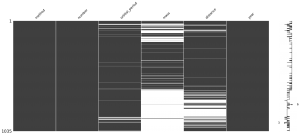
Uno de los problemas más habituales en los conjuntos de datos es la existencia de valores nulos o faltantes (missing values). La existencia de estos valores suele ser una señal de una mala calidad de datos, lo que afecta a la calidad de los posibles modelos que se pueden construir a partir de ellos, por lo que es necesario conocer el volumen del problema lo antes posible. Para … [Leer más...] acerca de Visualización de valores faltantes con Missingno
La implementación de GTD
GTD es una metodología de productividad personal que ha demostrado que funciona. A pesar de esto, es habitual encontrarse con personas para las que esta no ha funcionado debido a algunos errores que se cometen habitualmente durante su implementación. Errores que si se conocen son fáciles de evitar. Así, para conseguir una implementación de GTD con éxito no llega con saber los … [Leer más...] acerca de La implementación de GTD