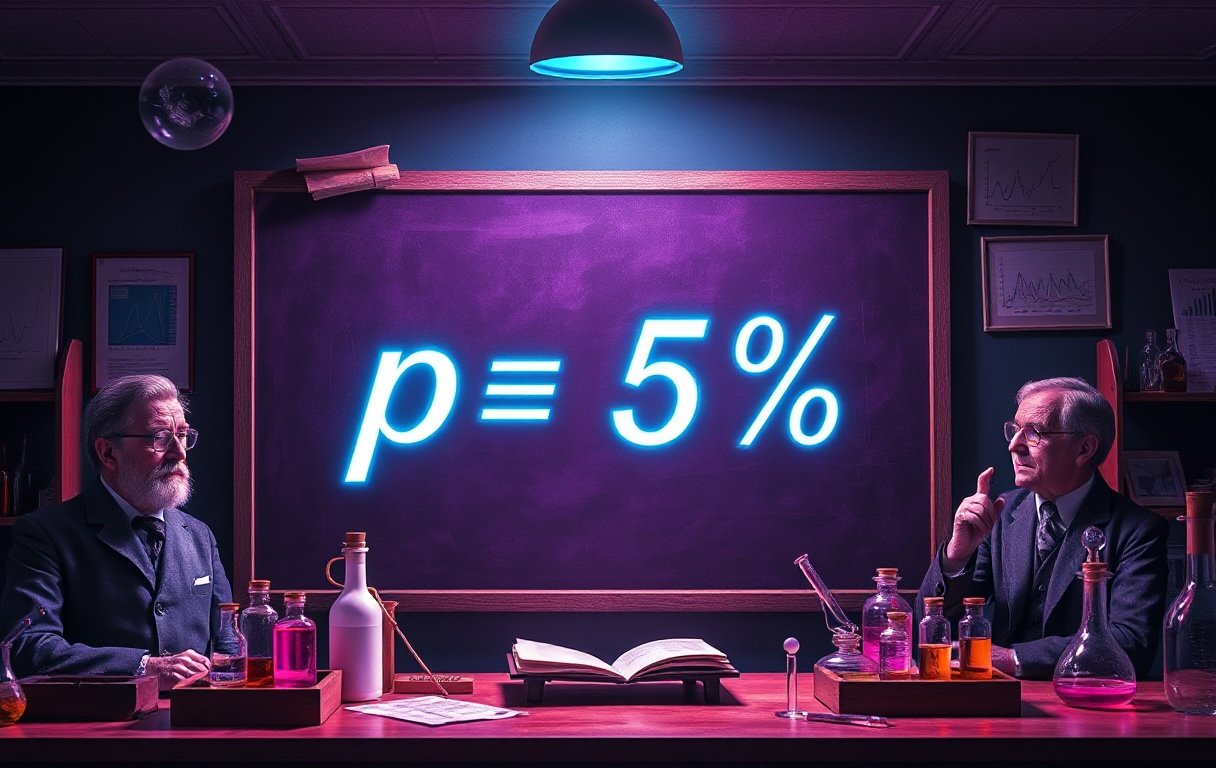
• Saltar al contenido principal
  • Skip to secondary menu
  • Saltar a la barra lateral principal
  • Saltar al pie de página
  • Inicio
  • Secciones
    • Ciencia de datos
    • Criptografía
    • Herramientas
    • Machine Learning
    • Noticias
    • Opinión
    • Productividad
    • Programación
      • JavaScript
      • Julia
      • Matlab
      • Python
      • R
  • Programación
    • JavaScript
    • Julia
    • Matlab
    • Python
    • R
  • Laboratorio
    • Estadística
      • Calculadora del Tamaño Muestral en Encuestas
      • Calculadora de estadísticos descriptivos
      • Test de normalidad
      • Calculadora de contrastes de hipotesis
      • Calculadora de tamano del efecto
      • Simulador de Regresión Lineal con Ruido
      • Descenso de gradiente
      • Visualizador de PCA
      • Visualizador de Series Temporales
      • Simulador de Regresión Logística
      • Matriz de confusión e informe de clasificación
      • Visualizador de fronteras de decisión
      • Simulador de K-Means
      • Número Óptimo de Clusters
      • Simulador de DBSCAN
      • Detector de la Ley de Benford
      • Ajuste de Curvas
      • Calculadora de Matrices
    • Probabilidad
      • Calculadora de Probabilidad de Distribuciones
      • Problema del cumpleaños
      • Calculadora de Probabilidades de Lotería
      • Simulador del Problema de Monty Hall
      • La aguja de Buffon
      • Simulador de la Estrategia Martingala
      • Simulador de Cadenas de Markov
    • Finanzas
      • Calculadora de Préstamos e Hipotecas
      • Conversor TIN ↔ TAE
      • Calculadora DCA con ajuste por inflación
      • Comparador de tarifas de luz 2.0TD
      • Calculadora XIRR con Flujos Irregulares
      • Simulador FIRE (Financial Independence, Retire Early)
      • Frontera Eficiente
    • Negocios
      • CLV
      • Scoring
    • Herramientas
      • Formateador / Minificador de JSON
      • Conversor CSV ↔ JSON
      • Consultar CSV con SQL en el navegador
      • Extractor de tickets (OCR)
      • Comparador y Formateador de Texto y JSON
      • Formateador y Tester de Expresiones Regulares
      • Inspector de JWT
      • Generador y verificador de hashes
      • Calculadora HMAC
      • Codificador / Decodificador Base64 y URL
      • Conversor de bases numericas
      • Conversor de Timestamp Unix
      • Conversor de colores
      • Generador de UUIDs
      • Editor de expresiones cron
      • Conversor de unidades
    • Juegos
      • Tres en Raya
      • Nim con Q-Learning
    • Más
      • Método D’Hondt
      • Generador de Contraseñas Seguras
  • Noticias
  • Boletín
  • Contacto
  • Tienda
    • Libros
    • Equipamiento de oficina
    • Equipamiento en movilidad

Analytics Lane

Ciencia e ingeniería de datos aplicada

  • Ciencia de datos
  • Machine Learning
  • IA Generativa
  • Python
  • Pandas
  • NumPy
  • R
  • Excel

Curiosidad: ¿Por qué usamos p < 0.05? Un umbral que cambió la historia de la ciencia

Curiosidades

octubre 2, 2025 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 3 minutos

En casi cualquier análisis estadístico —ya sea en medicina, psicología, economía o ciencia de datos— hay un valor que aparece como juez supremo: el famoso p < 0.05.

Si el valor p es menor que 0.05, decimos que el resultado es ”estadísticamente significativo”. Pero… ¿por qué ese número y no otro como 0.01 o 0.10? ¿Tiene algún fundamento teórico o fue elegido al azar?

La historia es más curiosa (y más humana) de lo que parece.

Un poco de historia: Ronald Fisher y el 0.05

El origen del umbral de 0.05 se remonta a los años 1920, gracias al estadístico británico Ronald A. Fisher, considerado uno de los padres de la estadística moderna.

En su libro “Statistical Methods for Research Workers” (1925), Fisher propuso que un valor p menor a 0.05 podría considerarse evidencia razonable contra la hipótesis nula. No fue una imposición rígida, sino más bien una sugerencia pragmática: un punto de referencia cómodo para decidir cuándo un resultado merecía atención.

¿Y por qué 0.05? No hay una razón matemática sagrada detrás del número. Fisher lo eligió por conveniencia: era un compromiso entre ser demasiado estricto (como p < 0.01) y demasiado permisivo (como p < 0.10). Además, permitía detectar efectos reales sin exigir cantidades enormes de datos, algo muy importante en una época donde no existan las computadoras.
Shallow copy vs Deep copy en Python: la mutación inesperada
En Analytics Lane
Shallow copy vs Deep copy en Python: la mutación inesperada

Sin embargo, lo que comenzó como una guía flexible se transformó con el tiempo en una regla rígida. A lo largo de las décadas, p < 0.05 se convirtió en el estándar informal para juzgar la validez de resultados científicos. En muchos campos, obtener un valor p por debajo de 0.05 se volvió prácticamente obligatorio para publicar un estudio.

¿Qué significa realmente p < 0.05?

El valor p (o valor de probabilidad) representa la probabilidad de obtener un resultado igual o más extremo que el observado, bajo la suposición de que la hipótesis nula es cierta.

Así que cuando decimos que p < 0.05, estamos aceptando una probabilidad del 5 % de cometer un error tipo I: es decir, rechazar una hipótesis verdadera por puro azar. Es como decir: “Estoy dispuesto a correr un pequeño riesgo —del 5 %— de equivocarme si eso me permite detectar un efecto real”.

Pero esto también significa que 1 de cada 20 resultados “significativos” podría ser simplemente ruido estadístico. Y cuando se hacen miles de pruebas —como en genética, estudios clínicos o pruebas de hipótesis múltiples— ese pequeño margen se acumula rápidamente.

Una reflexión final: ¿debemos seguir usando p < 0.05?

Aunque el p-valor sigue siendo una herramienta útil, muchos expertos en estadística y ciencia han cuestionado la obsesión con el 0.05. Algunos proponen ajustar el umbral según el contexto, otros sugieren emplear directamente los tamaños del efecto y los intervalos de confianza, y hay quien pide dejar de usar el p-valor como único criterio de decisión.

Después de todo, la significación estadística no implica relevancia práctica, y un resultado “no significativo” no siempre significa que no haya un efecto. Como tantas cosas en ciencia, la interpretación exige juicio, contexto y pensamiento crítico.

En resumen: p < 0.05 cambió la forma en que hacemos ciencia, pero entender sus límites es tan importante como saber calcularlo.

Nota: La imagen de este artículo fue generada utilizando un modelo de inteligencia artificial.

¿Te ha parecido de utilidad el contenido?

¡Puntúalo entre una y cinco estrellas!

Puntuación promedio 0 / 5. Votos emitidos: 0

Ya que has encontrado útil este contenido...

¡Síguenos en redes sociales!

¡Siento que este contenido no te haya sido útil!

¡Déjame mejorar este contenido!

Dime, ¿cómo puedo mejorar este contenido?

Publicaciones relacionadas

  • Shallow copy vs Deep copy en Python: la mutación inesperada
  • Cómo Proyectar Cuándo Alcanzarás la Independencia Financiera
  • Cómo Saber si una Diferencia Significativa es Importante
  • Curiosidad: “Wi-Fi” no significa “Wireless Fidelity”
  • Cómo Elegir el Test de Hipótesis Correcto para tus Datos
  • Qué significa realmente “calidad de datos”
  • Tuplas vs Listas en Python: parecen lo mismo, pero no
  • == vs is en Python: la diferencia que causa bugs misteriosos
  • Curiosidad: El puerto 80 y los números de puerto

Publicidad

Publicado en: Ciencia de datos, Opinión Etiquetado como: Curiosidades

Interacciones con los lectores

Deja una respuesta Cancelar la respuesta

Tu dirección de correo electrónico no será publicada. Los campos obligatorios están marcados con *

I accept the Terms and Conditions and the Privacy Policy

Este sitio usa Akismet para reducir el spam. Aprende cómo se procesan los datos de tus comentarios.

Barra lateral principal

Suscríbete a nuestro boletín

Suscríbete al boletín semanal para estar al día de todas las publicaciones.

Política de Privacidad

Analytics Lane en redes sociales

  • Amazon
  • Bluesky
  • Facebook
  • GitHub
  • Instagram
  • Mastodon
  • Pinterest
  • RSS
  • Telegram
  • Tumblr
  • Twitter
  • YouTube

Publicidad

Entradas recientes

Curiosidad: “Wi-Fi” no significa “Wireless Fidelity”

noviembre 12, 2026 Por Daniel Rodríguez

Shallow copy vs Deep copy en Python: la mutación inesperada

noviembre 10, 2026 Por Daniel Rodríguez

Cómo Saber si una Diferencia Significativa es Importante

noviembre 5, 2026 Por Daniel Rodríguez

Publicidad

Es tendencia

  • Numpy básico: seleccionar filas y columnas en matrices Numpy publicado el noviembre 6, 2019 | en Python
  • Comprobar hash SHA-256 o MD5 en Windows, macOS y Linux publicado el noviembre 1, 2023 | en Criptografía, Herramientas
  • Instantáneas de VirtualBox (Snapshots) publicado el marzo 27, 2019 | en Herramientas
  • Inclusión de texto en Matplotlib publicado el julio 19, 2022 | en Python
  • Copiar y pegar Activar copiar y pegar en VirtualBox publicado el mayo 1, 2019 | en Herramientas

Publicidad

Lo mejor valorado

4.9 (24)

Seleccionar filas y columnas en Pandas con iloc y loc

4.6 (16)

Archivos JSON con Python: lectura y escritura

4.4 (14)

Ordenación de diccionarios en Python mediante clave o valor

4.7 (13)

Operaciones de filtrado de DataFrame con Pandas en base a los valores de las columnas

4.1 (11)

Aplicar el método D’Hondt en Excel

Comentarios recientes

  • Daniel Rodríguez en Curiosidad: La Paradoja de Simpson, o por qué no siempre debes fiarte de los promedios
  • Hatepi en Curiosidad: La Paradoja de Simpson, o por qué no siempre debes fiarte de los promedios
  • Daniel Rodríguez en Los récords con asterisco, o la épica del titular sin contexto – El bestiario de los indicadores económicos absurdos (parte 8 y final)
  • Juan en Los récords con asterisco, o la épica del titular sin contexto – El bestiario de los indicadores económicos absurdos (parte 8 y final)
  • bif en JSON en bases de datos: cuándo es buena idea y cuándo no

Publicidad


Footer

Analytics Lane

  • Acerca de Analytics Lane
  • Boletín de noticias
  • Contacto
  • Libros
  • Lo más popular
  • Noticias
  • Tienda
  • Tiendas afiliadas

Secciones

  • Ciencia de datos
  • Criptografía
  • Herramientas
  • Machine Learning
  • Opinión
  • Productividad
  • Programación
  • Reseñas

Sobre de Analytics Lane

En Analytics Lane tratamos de explicar los principales conceptos de la ciencia e ingeniería de datos con un enfoque práctico. Los principales temas tratados son ciencia de datos, ingeniería de datos, inteligencia artificial, machine learning, deep learning y criptografía. Además, también se habla de los principales lenguajes de programación y herramientas utilizadas por los científicos e ingenieros de datos.

Copyright © 2018-2026 Analytics Lane ·Términos y condiciones ·Política de Cookies ·Política de Privacidad ·Herramientas de privacidad ·Contacto