Elegir el equipo adecuado para proyectos de Machine Learning e Inteligencia Artificial (IA) es un factor clave para alcanzar los objetivos propuestos. Tanto si estás dando tus primeros pasos en este campo, investigando nuevas fronteras tecnológicas, como si simplemente disfrutas explorando estas herramientas por hobby, contar con hardware adecuado puede marcar la diferencia. … [Leer más...] acerca de Ordenadores para Machine Learning e IA 2025: Guía para elegir el equipo ideal
Machine learning
Machine Learning (Aprendizaje Automático o Aprendizaje Máquina) es la rama de la inteligencia artificial que estudia cómo construir sistemas que puedan aprender automáticamente de la experiencia. Esto es, sistemas que puedan realizar mejores predicciones o tomar mejores decisiones a medida que aumenta su experiencia.
Los algoritmos de Machine Learning se dividen en tres categorías en función de los datos utilizados: aprendizaje supervisado, aprendizaje no supervisado y aprendizaje por refuerzo. En aprendizaje supervisado se utilizan conjuntos de datos, durante el proceso de entrenamiento, en los que se conoce el valor que debe reproducir el modelo. Pudiéndose medir el desempeño de los modelos en base a lo bien que reproduce posteriormente estos valores en otros conjuntos de datos. Tal como se puede intuir del nombre, en el caso de aprendizaje no supervisado, no se busca que los modelos reproducen un valor concreto. Siendo el objetivo de estos modelos identificar patrones que permitan separar y clasificar los datos en diferentes grupos. Por otro lado, en aprendizaje por refuerzo se busca la creación de agentes que pueden realizar acciones sobre un entorno. Siendo este un aprendizaje completamente diferente a los dos anteriores.
Inteligencia artificial generativa en banca: Cinco aplicaciones que están transformando el sector bancario
La revolución tecnológica impulsada por la inteligencia artificial (IA) está remodelando industrias enteras, y el sector bancario no es una excepción. En el corazón de esta transformación se encuentran los Modelos Avanzados de Lenguaje (LLM, por sus siglas en inglés, Large Language Models). Estas herramientas, como GPT (Generative Pre-trained Transformer), representan una … [Leer más...] acerca de Inteligencia artificial generativa en banca: Cinco aplicaciones que están transformando el sector bancario
Cómo instalar modelos de chat privados tipo GPT en tu ordenador: Guía paso a paso
Los modelos grandes de lenguaje (LLM, por sus siglas en inglés, Large Language Model) están marcando un antes y un después en la tecnología, transformando industrias y redefiniendo la interacción con la inteligencia artificial. Entre sus aplicaciones más populares destacan los chatbots, que han revolucionado nuestra forma de interactuar con la inteligencia artificial gracias a … [Leer más...] acerca de Cómo instalar modelos de chat privados tipo GPT en tu ordenador: Guía paso a paso
Justicio: La herramienta gratuita de IA para consultas legales
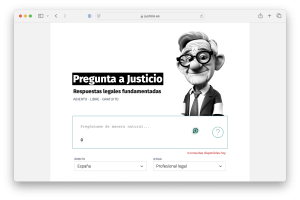
En nuestra vida diaria, las dudas legales pueden surgir en los momentos más inesperados, y contar con el apoyo de un abogado no siempre es posible. Para estos casos, surge una alternativa tecnológica que aprovecha la inteligencia artificial (IA) para ofrecer una solución accesible, rápida y sencilla. Justicio es una plataforma innovadora que utiliza IA para consultas legales en … [Leer más...] acerca de Justicio: La herramienta gratuita de IA para consultas legales
Cómo configurar Llama 3 en Python y Ollama: Todo lo que necesitas saber
Los modelos de lenguaje se han convertido en herramientas esenciales para tareas que van desde la generación de texto hasta la comprensión de lenguaje natural. Siendo posiblemente los exponentes de la era de la inteligencia artificial. Entre los modelos que se pueden usar en local destaca Llama 3, una de las últimas innovaciones de Meta. Al ofrecer características avanzadas con … [Leer más...] acerca de Cómo configurar Llama 3 en Python y Ollama: Todo lo que necesitas saber
Aprovecha un 40% de descuento en Coursera Plus para impulsar tus habilidades en Ciencia de Datos e Inteligencia Artificial
Para aquellos interesados en profundizar en Ciencia de Datos, Machine Learning, Inteligencia Artificial u otras áreas, este es un momento perfecto. Coursera Plus ofrece un 40% de descuento en su suscripción anual hasta el 2 de diciembre de 2024, lo que significa se puede acceder a más de 7,000 cursos incluidos los Certificados Profesionales de Google, Meta, Microsoft e IBM, … [Leer más...] acerca de Aprovecha un 40% de descuento en Coursera Plus para impulsar tus habilidades en Ciencia de Datos e Inteligencia Artificial
Aprendizaje Semisupervisado

En el campo del Aprendizaje Automático (Machine Learning) los enfoques de aprendizaje se suelen dividir en tres: aprendizaje supervisado, aprendizaje no supervisado y aprendizaje por refuerzo. Siendo los dos primeros los más utilizados. En el aprendizaje supervisado se usan conjuntos de datos etiquetados para entrenar modelos que buscan identificar estas etiquetas. Mientras que … [Leer más...] acerca de Aprendizaje Semisupervisado
Entendiendo la validación cruzada: Selección de la profundidad óptima en un árbol de decisión

En aprendizaje automático uno de los mayores desafíos es entrenar modelos que funcionen bien sobre datos nuevos. Evitando que el sobreajuste que un modelo es bueno cuando en realidad solo está memorizado las predicciones. En este punto es cuando entra en juego la técnica de la validación cruzada. En esta entrada, se explicará por qué la validación cruzada es importante, y cómo … [Leer más...] acerca de Entendiendo la validación cruzada: Selección de la profundidad óptima en un árbol de decisión
Los mejores conjuntos de datos para Machine Learning

Disponer de conjuntos de datos de calidad es crucial para poder construir modelos de aprendizaje automático (Machine Learning) robustos, precisos y funcionales. Como se suele decir “Basura entra, basura sale” (Garbage In-Garbage Out). Esto es algo que se nota especialmente cuando se está aprendiendo a crear modelos de aprendizaje automático, cuando no se dispone de datos reales … [Leer más...] acerca de Los mejores conjuntos de datos para Machine Learning
Detectando anomalías con Angle-Based Outlier Detection (ABOD)
La detección de anomalías (también conocidos por su nombre en inglés outliers) son métodos de aprendizaje automático claves en múltiples sectores. Facilitando la identificación de eventos como fraudes, errores en los datos o eventos raros. Entre los métodos existentes para ello, Angle-Based Outlier Detection (ABOD) destaca con un enfoque único al usar los ángulos entre los … [Leer más...] acerca de Detectando anomalías con Angle-Based Outlier Detection (ABOD)
Explorando Clustering-Based Local Outlier Factor (CBLOF) para la detección de anomalías
La detección de anomalías es una parte del aprendizaje automático resulta clave en múltiples aplicaciones. Poder saber qué registros son atípicos de un conjunto de datos resulta fundamental en sectores como la seguridad informática, el mantenimiento predictivo o la detección de fraudes. Uno de los algoritmos que se pueden emplear en estos casos es Clustering-Based Local Outlier … [Leer más...] acerca de Explorando Clustering-Based Local Outlier Factor (CBLOF) para la detección de anomalías
Análisis de correlación para modelos de regresión: Cómo eliminar la multicolinealidad y mejorar la robustez

Los modelos de regresión son una de las técnicas estadísticas más utilizadas para comprender y predecir las relaciones entre las variables. Siendo ampliamente utilizadas en análisis de datos y aprendizaje automático. Sin embargo, cuando las variables que se desean utilizar para la construcción del modelo están altamente correlacionadas, aparece el problema de la … [Leer más...] acerca de Análisis de correlación para modelos de regresión: Cómo eliminar la multicolinealidad y mejorar la robustez