Las anomalías, también conocidas como ”outliers”, son puntos que se desvían significativamente de la mayoría de los otros puntos en un conjunto de datos. Por lo que saber detectarlas es una tarea clave en múltiples aplicaciones. Empezando por la seguridad informática, donde los ataques tienen un patrón diferente al uso legítimo de los recursos, hasta en mantenimiento … [Leer más...] acerca de Descubriendo anomalías con HBOS (Histogram-Based Outlier Score)
Machine learning
Machine Learning (Aprendizaje Automático o Aprendizaje Máquina) es la rama de la inteligencia artificial que estudia cómo construir sistemas que puedan aprender automáticamente de la experiencia. Esto es, sistemas que puedan realizar mejores predicciones o tomar mejores decisiones a medida que aumenta su experiencia.
Los algoritmos de Machine Learning se dividen en tres categorías en función de los datos utilizados: aprendizaje supervisado, aprendizaje no supervisado y aprendizaje por refuerzo. En aprendizaje supervisado se utilizan conjuntos de datos, durante el proceso de entrenamiento, en los que se conoce el valor que debe reproducir el modelo. Pudiéndose medir el desempeño de los modelos en base a lo bien que reproduce posteriormente estos valores en otros conjuntos de datos. Tal como se puede intuir del nombre, en el caso de aprendizaje no supervisado, no se busca que los modelos reproducen un valor concreto. Siendo el objetivo de estos modelos identificar patrones que permitan separar y clasificar los datos en diferentes grupos. Por otro lado, en aprendizaje por refuerzo se busca la creación de agentes que pueden realizar acciones sobre un entorno. Siendo este un aprendizaje completamente diferente a los dos anteriores.
Introducción al Análisis de Componentes Principales (PCA)
El Análisis de Componentes Principales (PCA) es una técnica ampliamente utilizado en aprendizaje automático. Se utiliza para reducir la dimensionalidad (el número de variables o columnas) de los conjuntos de datos manteniendo al mismo tiempo la mayor cantidad de información posible. PCA transforma las variables originales en otras nuevas, llamadas componentes principales, … [Leer más...] acerca de Introducción al Análisis de Componentes Principales (PCA)
Desmitificando Elliptic Envelope: Una exploración de la detección de anomalías con estimación de covarianza elíptica
Entre los algoritmos de Machine Learning para la detección de anomalías Elliptic Envelope destaca por su capacidad para modelar la distribución de los datos utilizando una elipse en el espacio de características. Un enfoque efectivo para identificar anomalías en conjuntos de datos multivariados donde la mayoría de los datos se distribuyen de manera normal. Lo que lo convierte … [Leer más...] acerca de Desmitificando Elliptic Envelope: Una exploración de la detección de anomalías con estimación de covarianza elíptica
Tres libros para celebrar el Día del Libro aprendiendo sobre Machine Learning
Hoy es el día del libro. Qué mejor manera de celebrar este día que recomendar tres libros esenciales sobre Aprendizaje Automático y Machine Learning. Unos libros que son adecuados tanto para introducirse en el campo como para profundizar en temas más avanzados. Además, todos ellos, a pesar de estar escritos originalmente en inglés, cuentan con traducciones al español que los … [Leer más...] acerca de Tres libros para celebrar el Día del Libro aprendiendo sobre Machine Learning
La distancia de Mahalanobis
Dentro del aprendizaje automático, es habitual tener que trabajar con conjuntos de datos multidimensionales donde las variables están interrelacionadas. En estos casos, para cuantificar la similitud entre puntos, es aconsejable tener en cuenta la estructura de los propios datos. Algo que no sucede en las distancias usadas habitualmente como la Euclídea. Una métrica que si tiene … [Leer más...] acerca de La distancia de Mahalanobis
Explorando Local Outlier Factor (LOF): Un enfoque eficaz para la detección de anomalías
Los modelos de detección de anomalías es una parte del aprendizaje automático en la que cada vez existe un mayor interés. Siendo una tarea crítica en diferentes áreas como la seguridad informática, el mantenimiento predictivo o el monitoreo de la salud. Uno de los algoritmos más populares para esta tarea es Local Outlier Factor (LOF). Este algoritmo identifica las anomalías de … [Leer más...] acerca de Explorando Local Outlier Factor (LOF): Un enfoque eficaz para la detección de anomalías
Introducción a XGBoost: Instalación y primeros pasos

XGBoost (Extreme Gradient Boosting) es un algoritmo que ha ganado popularidad entre los científicos de datos debido a su potencia y eficiencia. En esta entrada se explicará qué es XGBoost, cómo instalarlo en Python y un cómo se puede usar en un caso práctico.¿Qué es XGBoost?XGBoost es un algoritmo de aprendizaje supervisado basado en árboles de decisión, diseñado para … [Leer más...] acerca de Introducción a XGBoost: Instalación y primeros pasos
Normalización de datos: Maximizando el rendimiento de los modelos de Aprendizaje Automático

La preparación de los datos es una parte clave del éxito de los modelos de aprendizaje automático o Machine Learning. Siendo una parte fundamental del trabajo para garantizar que los modelos puedan aprender de manera efectiva y eficiente. Una de las técnicas más sencillas y utilizadas durante la fase de preparación de los datos es la normalización de datos. En esta entrada, se … [Leer más...] acerca de Normalización de datos: Maximizando el rendimiento de los modelos de Aprendizaje Automático
One-Class SVM: Detección de anomalías con máquinas de vector soporte
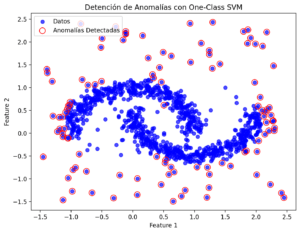
La detección de anomalías es una de las aplicaciones del aprendizaje no supervisado más utilizadas. Siendo una técnica que se emplea en casos tan diferentes como la detección de ataques cibernéticos, la detección de problemas de salud o la identificación de aplicaciones fraudulentas en servicios financieros o seguros. En todos los casos, identificar anomalías requiere localizar … [Leer más...] acerca de One-Class SVM: Detección de anomalías con máquinas de vector soporte
Isolation Forest: Detectando Anomalías con Eficacia
La detección de anomalías es uno de los desafíos más intrigantes del aprendizaje automático. Ya sea en el campo de la seguridad informática, la detección de fraudes financieros o en tareas de mantenimiento predictivo, identificar valores anómalos dentro de grandes conjuntos de datos es clave para evitar problemas en las operaciones. En esta entrada se explicará el algoritmo de … [Leer más...] acerca de Isolation Forest: Detectando Anomalías con Eficacia
Resumir PDF con Python y OpenAI

Actualmente, los documentos PDF son una parte fundamental para el intercambio de información. Siendo un formato omnipresente. Es normal encontrarse con ellos en una amplia gama de contextos como los informes empresariales, los documentos académicos y la publicación de normativa. Por ello es habitual encontrarse con la necesidad de extraer la información relevante de miles de … [Leer más...] acerca de Resumir PDF con Python y OpenAI
Selección del valor óptimo de K en SelecKBest de scikit-learn
Para poder entrenar un modelo de aprendizaje automático de forma correcta es necesario seleccionar las características. Un proceso clave para mejorar el rendimiento de los modelos. En Python, uno de los posibles métodos para ello es SelectKBest (o su equivalente SelectPercentile). Una de las herramientas de selección de características que se encuentran disponibles en … [Leer más...] acerca de Selección del valor óptimo de K en SelecKBest de scikit-learn