• Saltar al contenido principal
  • Skip to secondary menu
  • Saltar a la barra lateral principal
  • Saltar al pie de página
  • Inicio
  • Secciones
    • Ciencia de datos
    • Criptografía
    • Herramientas
    • Machine Learning
    • Noticias
    • Opinión
    • Productividad
    • Programación
      • JavaScript
      • Julia
      • Matlab
      • Python
      • R
  • Programación
    • JavaScript
    • Julia
    • Matlab
    • Python
    • R
  • Laboratorio
    • Estadística
      • Calculadora del Tamaño Muestral en Encuestas
      • Calculadora de estadísticos descriptivos
      • Test de normalidad
      • Calculadora de contrastes de hipotesis
      • Calculadora de tamano del efecto
      • Simulador de Regresión Lineal con Ruido
      • Visualizador de PCA
      • Visualizador de Series Temporales
      • Simulador de Regresión Logística
      • Simulador de K-Means
      • Simulador de DBSCAN
      • Detector de la Ley de Benford
      • Ajuste de Curvas
      • Calculadora de Matrices
    • Probabilidad
      • Calculadora de Probabilidad de Distribuciones
      • Calculadora de Probabilidades de Lotería
      • Simulador del Problema de Monty Hall
      • Simulador de la Estrategia Martingala
    • Finanzas
      • Calculadora de Préstamos e Hipotecas
      • Conversor TIN ↔ TAE
      • Calculadora DCA con ajuste por inflación
      • Calculadora XIRR con Flujos Irregulares
      • Simulador FIRE (Financial Independence, Retire Early)
    • Negocios
      • CLV
      • Scoring
    • Herramientas
      • Formateador / Minificador de JSON
      • Conversor CSV ↔ JSON
      • Comparador y Formateador de Texto y JSON
      • Formateador y Tester de Expresiones Regulares
      • Inspector de JWT
      • Generador y verificador de hashes
      • Codificador / Decodificador Base64 y URL
      • Conversor de bases numericas
      • Conversor de Timestamp Unix
      • Conversor de colores
      • Generador de UUIDs
    • Juegos
      • Tres en Raya
      • Nim con Q-Learning
    • Más
      • Método D’Hondt
      • Generador de Contraseñas Seguras
  • Noticias
  • Boletín
  • Contacto
  • Tienda
    • Libros
    • Equipamiento de oficina
    • Equipamiento en movilidad

Analytics Lane

Ciencia e ingeniería de datos aplicada

  • Ciencia de datos
  • Machine Learning
  • IA Generativa
  • Python
  • Pandas
  • NumPy
  • R
  • Excel

Sincronizar múltiples ejes con twinx(): Comparación de datos con diferentes escalas en un solo gráfico con Matplotlib

Matplotlib

mayo 5, 2025 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 3 minutos

Al realizar un análisis de datos, a menudo necesitamos comparar la evolución de dos series de datos relacionadas entre sí, pero con escalas completamente diferentes. Por ejemplo:

  • Comparar la temperatura promedio de una región con las ventas de helados en la misma.
  • Analizar el volumen de lluvia mensual frente al crecimiento agrícola.

Un gráfico tradicional con un solo eje Y no puede mostrar correctamente ambos conjuntos de datos debido a las diferencias existentes en las escalas de los mismos. Por ejemplo, mientras la temperatura esté en decenas de grados, las ventas de helados tendrán valores de miles o millones de euros. Por eso, si intentamos superponer estas series, una podría dominar el gráfico, haciendo que el otro pase desapercibido.

Para resolver este tipo de problemas, Matplotlib ofrece la función twinx(), que permite agregar un segundo eje Y al mismo gráfico. Este método es ideal para mostrar datos con diferentes escalas en una única visualización, conservando claridad y precisión.

En esta entrada, explicaremos cómo usar twinx(), implementarlo con ejemplos prácticos y personalizarlo para tus necesidades.

Tabla de contenidos

  • 1. Para qué sirve twinx() de Matplotlib
    • 1.1. Ventajas de usar twinx() en Matplotlib
  • 2. Ejemplo práctico: Comparar temperatura y ventas de helados
  • 3. Personalización de twinx()
    • 3.1. Usar diferentes estilos para cada eje
    • 3.2. Agregar leyendas específicas para cada eje Y
  • 4. Conclusiones

Para qué sirve twinx() de Matplotlib

La función twinx() de Matplotlib permite crear un segundo eje Y en un gráfico existente. Este nuevo eje comparte el eje X con el gráfico original, pero tiene su propia escala independiente. Lo que facilita:
Shallow copy vs Deep copy en Python: la mutación inesperada
En Analytics Lane
Shallow copy vs Deep copy en Python: la mutación inesperada

  • Superponer dos gráficos diferentes con escalas Y distintas.
  • Facilitar la comparación visual de datos relacionados.

Ventajas de usar twinx() en Matplotlib

Algunas de las ventajas que ofrece el uso de twinx() de Matplotlib es nuestros gráficos son:

  • Claridad visual: Ambos conjuntos de datos se presentan en el mismo espacio visual, pero con escalas separadas.
  • Personalización: Cada eje Y puede tener etiquetas, colores y estilos propios.
  • Eficiencia: Permite comparar series relacionadas sin necesidad de gráficos separados.

Ejemplo práctico: Comparar temperatura y ventas de helados

Imaginemos un conjunto de datos que contiene las temperaturas promedio y las ventas de helados por mes en un año. El siguiente código muestra cómo definir los valores y crear una gráfica con estas características.

import matplotlib.pyplot as plt

# Datos ficticios
meses = ["Ene", "Feb", "Mar", "Abr", "May", "Jun", "Jul", "Ago", "Sep", "Oct", "Nov", "Dic"]
temperaturas = [5, 7, 12, 18, 22, 27, 30, 28, 24, 18, 12, 7]
ventas_helados = [200, 250, 300, 500, 700, 900, 1200, 1100, 800, 400, 300, 250]

# Crear la figura y el primer eje
fig, ax1 = plt.subplots()

# Graficar la temperatura en el primer eje
ax1.plot(meses, temperaturas, color='blue', marker='o', label="Temperatura (°C)")
ax1.set_xlabel("Meses")
ax1.set_ylabel("Temperatura (°C)", color='blue')
ax1.tick_params(axis='y', labelcolor='blue')

# Crear un segundo eje Y compartiendo el eje X
ax2 = ax1.twinx()
ax2.plot(meses, ventas_helados, color='red', marker='s', label="Ventas de helados")
ax2.set_ylabel("Ventas de helados", color='red')
ax2.tick_params(axis='y', labelcolor='red')

# Títulos y leyendas
plt.title("Relación entre temperatura y ventas de helados")
fig.tight_layout()
plt.show()

Obteniendo como resultado una gráfica donde el eje Y izquierdo muestra la escala de temperatura (°C), mientras que el eje Y derecho muestra la escala de ventas de helados. Ambos gráficos comparten el eje X con los meses del año, como se puede ver en la siguiente figura.
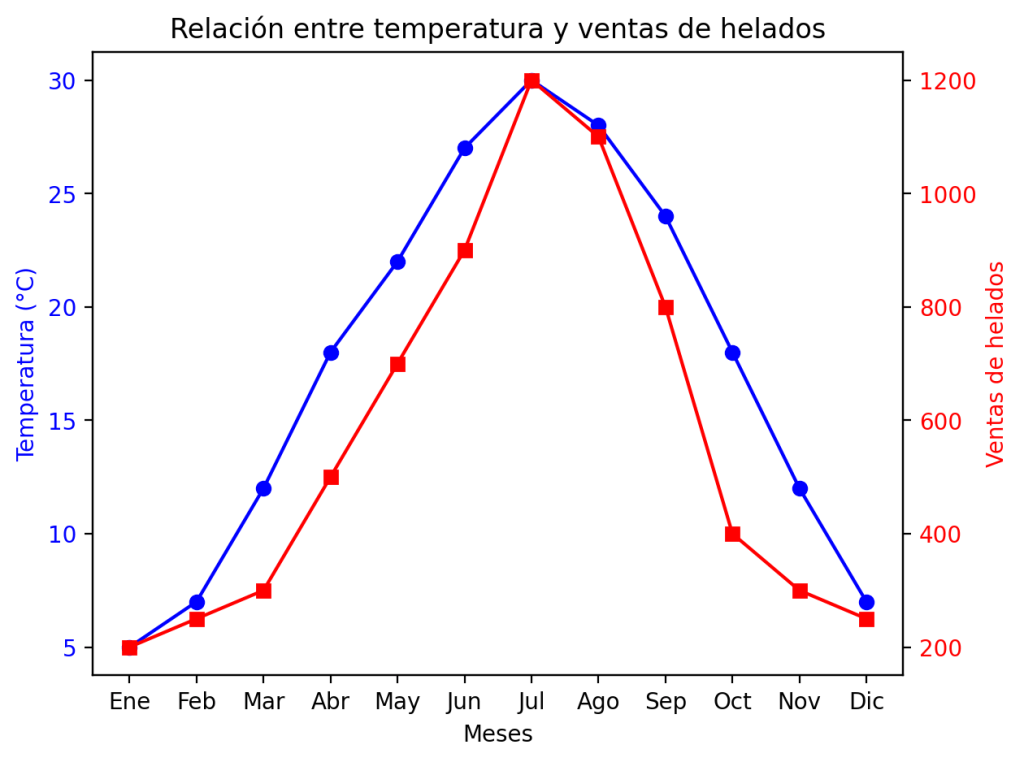
Gráfico que muestra cómo, gracias al uso de twinx, es posible representar simultáneamente la relación entre dos variables —temperatura y ventas de helados— aunque estén medidas en escalas muy diferentes.
Relación entre la temperatura (°C) y las ventas de helados (unidades), representadas con escalas distintas mediante twinx.

Personalización de twinx()

Como casi todas las funciones de Matplotlib existen múltiples opciones de personalización para adaptar la salida a nuestras necesidades concretar.

Usar diferentes estilos para cada eje

Puedes personalizar los colores, las líneas y los marcadores para diferenciar claramente ambos conjuntos de datos.

# Personalizar estilos
ax1.plot(meses, temperaturas, color='blue', linestyle='--', linewidth=2, marker='o', label="Temperatura (°C)")
ax2.plot(meses, ventas_helados, color='red', linestyle='-', linewidth=2, marker='s', label="Ventas de helados")

Agregar leyendas específicas para cada eje Y

Las leyendas pueden ayudar a interpretar gráficos con múltiples ejes, por eso se puede agregar una leyenda específica a cada eje.

# Agregar leyendas específicas
ax1.legend(loc='upper left')
ax2.legend(loc='upper right')

Conclusiones

El uso de twinx() en Matplotlib es una gran opción para comparar datos con diferentes escalas en un solo gráfico. Desde el análisis de tendencias climáticas hasta la exploración de relaciones económicas, esta herramienta permite crear visualizaciones claras y efectivas que destacan la relación entre variables.

¿Te ha parecido de utilidad el contenido?

¡Puntúalo entre una y cinco estrellas!

Puntuación promedio 0 / 5. Votos emitidos: 0

Ya que has encontrado útil este contenido...

¡Síguenos en redes sociales!

¡Siento que este contenido no te haya sido útil!

¡Déjame mejorar este contenido!

Dime, ¿cómo puedo mejorar este contenido?

Publicaciones relacionadas

  • Shallow copy vs Deep copy en Python: la mutación inesperada
  • Cómo Proyectar Cuándo Alcanzarás la Independencia Financiera
  • Cómo Saber si una Diferencia Significativa es Importante
  • Cómo Elegir el Test de Hipótesis Correcto para tus Datos
  • Qué significa realmente “calidad de datos”
  • Cómo Detectar Pseudo-IDs y Data Leakage en el Constructor de Scorecards
  • Tuplas vs Listas en Python: parecen lo mismo, pero no
  • == vs is en Python: la diferencia que causa bugs misteriosos
  • Curiosidad: El puerto 80 y los números de puerto

Publicidad

Publicado en: Python Etiquetado como: Matplotlib

Interacciones con los lectores

Deja una respuesta Cancelar la respuesta

Tu dirección de correo electrónico no será publicada. Los campos obligatorios están marcados con *

I accept the Terms and Conditions and the Privacy Policy

Este sitio usa Akismet para reducir el spam. Aprende cómo se procesan los datos de tus comentarios.

Barra lateral principal

Suscríbete a nuestro boletín

Suscríbete al boletín semanal para estar al día de todas las publicaciones.

Política de Privacidad

Analytics Lane en redes sociales

  • Amazon
  • Bluesky
  • Facebook
  • GitHub
  • Instagram
  • Mastodon
  • Pinterest
  • RSS
  • Telegram
  • Tumblr
  • Twitter
  • YouTube

Publicidad

Entradas recientes

Shallow copy vs Deep copy en Python: la mutación inesperada

noviembre 10, 2026 Por Daniel Rodríguez

Cómo Saber si una Diferencia Significativa es Importante

noviembre 5, 2026 Por Daniel Rodríguez

== vs is en Python: la diferencia que causa bugs misteriosos

noviembre 3, 2026 Por Daniel Rodríguez

Publicidad

Es tendencia

  • Gráficos de barras en Matplotlib publicado el julio 5, 2022 | en Python
  • Error: No se puede cargar el archivo porque la ejecución de scripts está deshabilitada en este sistema Solución a los problemas de ejecución de scripts en Windows 11 cuando se da el mensaje: “No se puede cargar el archivo porque la ejecución de scripts está deshabilitada en este sistema” publicado el febrero 14, 2024 | en Herramientas
  • Copiar y pegar Activar copiar y pegar en VirtualBox publicado el mayo 1, 2019 | en Herramientas
  • Hoja en la que se puede obtener el último valor de una columna en Excel Obtener el último valor de una columna en Excel publicado el mayo 5, 2021 | en Herramientas
  • Diferencia entre R2 y R2 ajustado en modelos de regresión publicado el marzo 8, 2024 | en Ciencia de datos

Publicidad

Lo mejor valorado

4.9 (24)

Seleccionar filas y columnas en Pandas con iloc y loc

4.6 (16)

Archivos JSON con Python: lectura y escritura

4.4 (14)

Ordenación de diccionarios en Python mediante clave o valor

4.7 (13)

Operaciones de filtrado de DataFrame con Pandas en base a los valores de las columnas

4.1 (11)

Aplicar el método D’Hondt en Excel

Comentarios recientes

  • Daniel Rodríguez en Curiosidad: La Paradoja de Simpson, o por qué no siempre debes fiarte de los promedios
  • Hatepi en Curiosidad: La Paradoja de Simpson, o por qué no siempre debes fiarte de los promedios
  • Daniel Rodríguez en Los récords con asterisco, o la épica del titular sin contexto – El bestiario de los indicadores económicos absurdos (parte 8 y final)
  • Juan en Los récords con asterisco, o la épica del titular sin contexto – El bestiario de los indicadores económicos absurdos (parte 8 y final)
  • bif en JSON en bases de datos: cuándo es buena idea y cuándo no

Publicidad


Footer

Analytics Lane

  • Acerca de Analytics Lane
  • Boletín de noticias
  • Contacto
  • Libros
  • Lo más popular
  • Noticias
  • Tienda
  • Tiendas afiliadas

Secciones

  • Ciencia de datos
  • Criptografía
  • Herramientas
  • Machine Learning
  • Opinión
  • Productividad
  • Programación
  • Reseñas

Sobre de Analytics Lane

En Analytics Lane tratamos de explicar los principales conceptos de la ciencia e ingeniería de datos con un enfoque práctico. Los principales temas tratados son ciencia de datos, ingeniería de datos, inteligencia artificial, machine learning, deep learning y criptografía. Además, también se habla de los principales lenguajes de programación y herramientas utilizadas por los científicos e ingenieros de datos.

Copyright © 2018-2026 Analytics Lane ·Términos y condiciones ·Política de Cookies ·Política de Privacidad ·Herramientas de privacidad ·Contacto