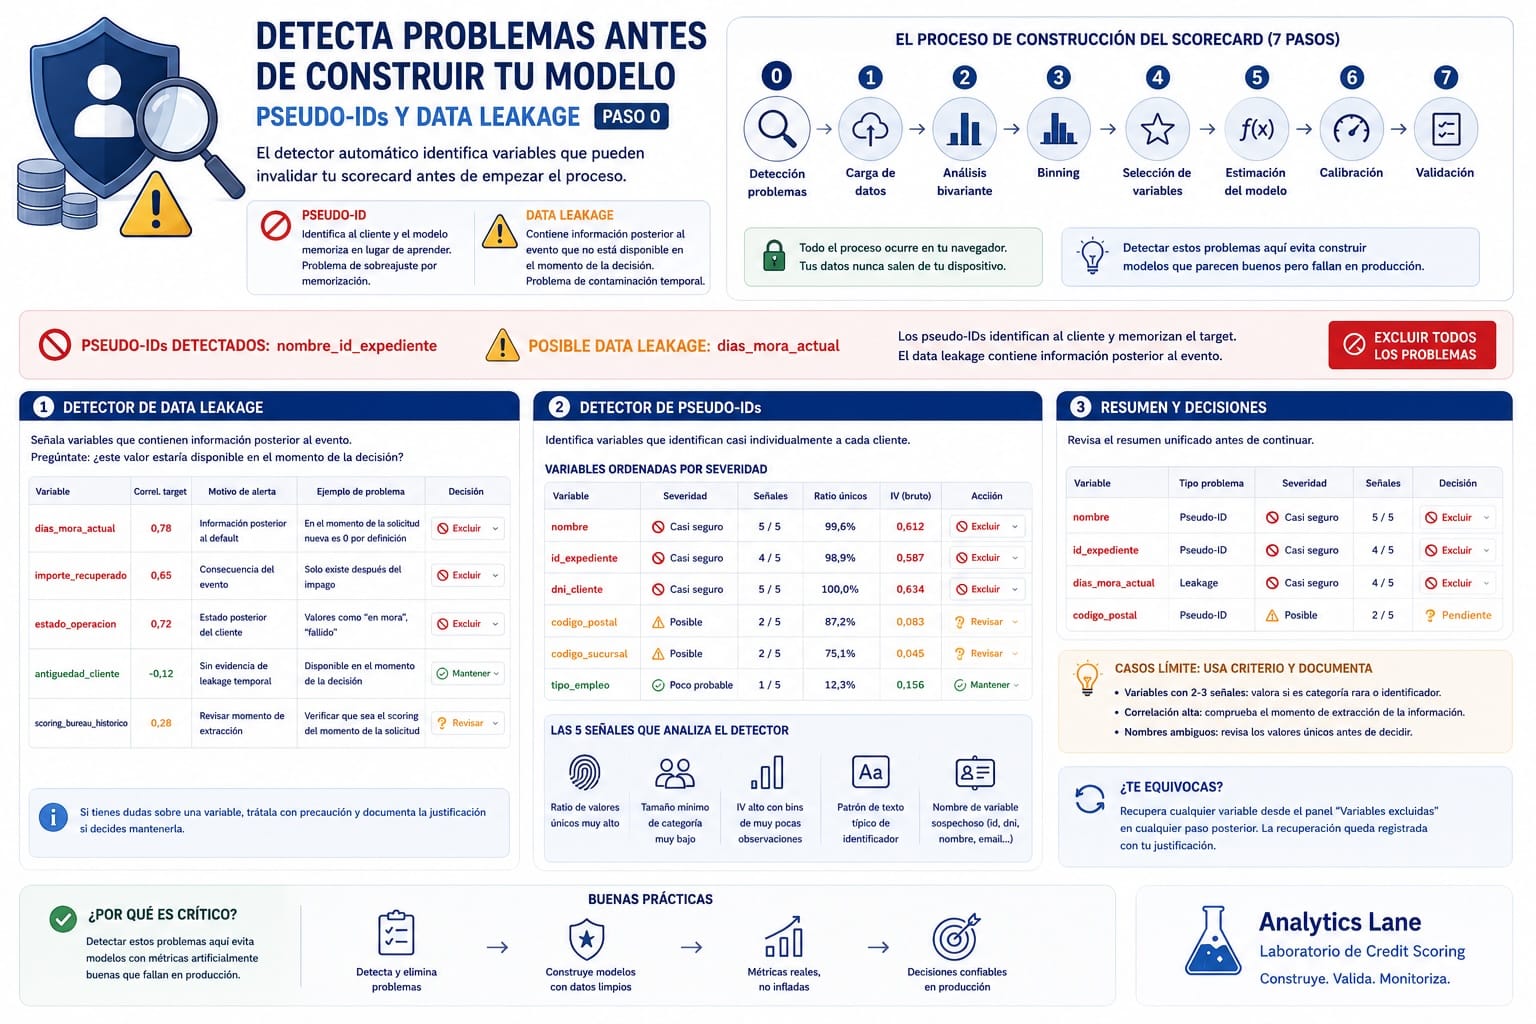
El artículo Data Leakage en Credit Scoring explicó por qué este es el error más silencioso y más costoso en la construcción de un scorecard: un modelo contaminado con información del futuro puede mostrar métricas de validación excelentes y ser completamente inútil en producción.
Este tutorial muestra cómo usar el detector automático del constructor de scorecards del laboratorio de Analytics Lane o ScoreFlow para identificar estos problemas en el paso 0, antes de avanzar al resto del proceso. Veremos los dos detectores por separado (pseudo-IDs y data leakage) porque, aunque ambos producen síntomas parecidos (métricas de validación artificialmente buenas), tienen causas y soluciones distintas.
Por qué son dos problemas distintos
Antes de entrar en el detector, vale la pena recordar la diferencia:
- Un pseudo-ID es una variable que identifica casi individualmente a cada cliente: un nombre, un DNI, un número de expediente. El modelo la memoriza en lugar de aprender una relación generalizable. El problema es de sobreajuste por memorización.
- El data leakage es una variable que contiene información posterior al evento de default: días en mora, importe recuperado, estado de impago. El modelo aprende una relación real pero inútil porque esa información no existe en el momento real de la decisión. El problema es de contaminación temporal.
El constructor los señala con iconos distintos — ⛔ para pseudo-IDs, ⚠️ para leakage — precisamente para que no se confundan en el momento de decidir qué hacer con cada variable.
Paso 1: Carga tu conjunto de datos
Entra en el constructor de scorecards o ScoreFlow y carga tu conjunto de datos, ya sea pegándolo directamente, arrastrando un archivo CSV o usando uno de los datasets de ejemplo disponibles.
El la fase 2, durante el análisis univariante, el constructor ejecuta automáticamente ambos detectores. Si encuentra variables problemáticas, verás un banner en la parte superior del paso 2:
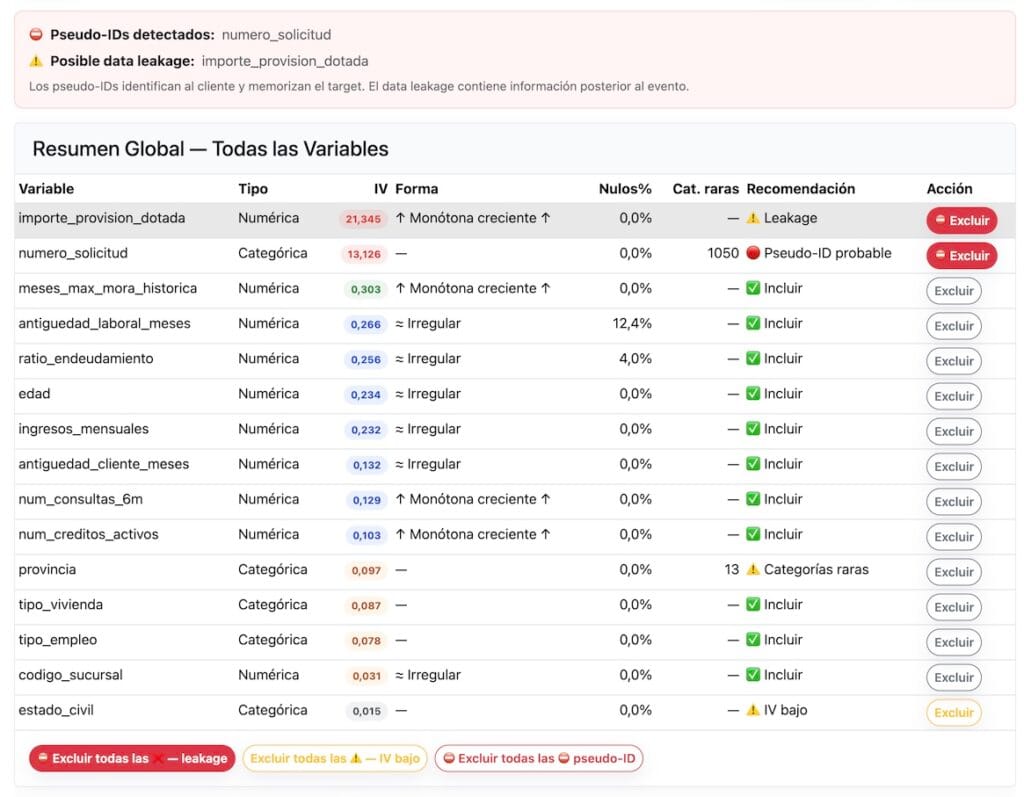
En este punto la aplicación permite eliminar directamente todas las variables problemáticas, las que son Pseudo-IDs o los posibles data leakage. Si no se elimina en esta fase, hay una nueva oportunidad en el paso 4 después del proceso de Binning, pero es difícil que estos problemas se solucionen.
Paso 2: Revisa las variables dictadas como posible data leakage
A diferencia de los pseudo-IDs, el data leakage requiere siempre que te hagas la pregunta explícita que aparece en la ficha: ¿este valor estaría disponible en el momento real de la decisión? Si la respuesta es no, como en dias_mora_actual, que por definición es cero en el momento de una solicitud nueva, excluye la variable sin dudarlo.
Si tienes dudas sobre una variable concreta porque no conoces exactamente cómo se calculó o en qué momento se extrajo del sistema, trátala con precaución: o bien la excluyes de forma conservadora, o bien la mantienes con una justificación detallada que documente por qué crees que es segura, esa documentación será valiosa si más adelante hay que auditar el modelo.
Paso 3: Revisa el detector de pseudo-IDs
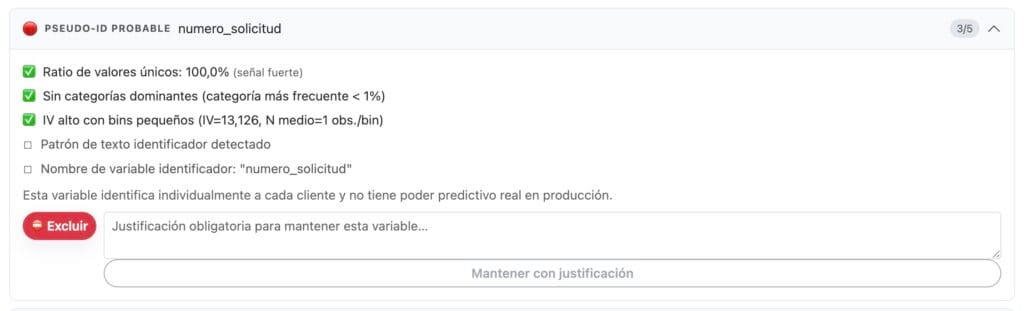
En el paso 4 de la aplicación, selección de variables, la primera sección muestra todas las variables detectadas como posibles pseudo-IDs que no han sido eliminadas previamente, clasificadas por severidad según cuántas de las cinco señales se cumplen:
- Ratio de valores únicos alto
- Tamaño mínimo de categoría muy bajo
- IV alto calculado sobre bins con pocas observaciones
- Patrón de texto típico de identificador
- Nombre de variable sospechoso (id, nombre, dni, email…)
Ejemplo de ficha que verás
Qué hacer
Si una variable tiene 4 o 5 señales detectadas, la decisión correcta casi siempre es excluirla. Pulsa el botón “Excluir todos los pseudo-IDs ⛔” en el resumen para limpiar de golpe todos los casos de severidad crítica.
Para los casos de severidad media o baja (2-3 señales), revisa la ficha individual antes de decidir. Por ejemplo, una variable codigo_producto con pocas categorías pero un nombre que contiene “codigo” puede activar la señal del nombre sin ser realmente un identificador. En ese caso, mantenla, pero el constructor te pedirá una breve justificación que quedará registrada en el log de decisiones.
Paso 4: Casos límite que requieren más criterio
No todas las variables marcadas son tan evidentes como el ejemplo anterior. Algunos casos típicos que requieren más reflexión:
- Una variable con 2-3 señales de pseudo-ID: Por ejemplo
codigo_postalcon miles de categorías únicas. No es exactamente un identificador del cliente, pero su altísima cardinalidad hace que muchas categorías tengan muy pocas observaciones, el mismo problema de fondo que un pseudo-ID, aunque por una razón distinta (categorías raras, no identificación individual). En este caso la solución no es necesariamente excluir la variable sino agruparla, algo que puedes hacer la fase 3 de binning, con las estrategias de agrupación de categorías raras. - Una variable con correlación alta pero explicación razonable: Por ejemplo
scoring_bureau_actualcon correlación 0,65 con el target. Si el bureau de crédito actualiza sus puntuaciones con información de mora reciente, esta variable puede contener leakage parcial. Si tienes certeza de que el scoring que estás usando es el histórico, el que existía en el momento de la solicitud, no el actual, puedes mantenerla con esa justificación documentada. - Variables con nombres ambiguos: Una variable llamada simplemente
estadopuede ser inocua (estado civil) o sospechosa (estado de la operación, con valores de mora). El detector la marcará solo si los valores categóricos contienen términos sospechosos. Si el nombre te genera dudas pero el detector no la marca, revisa manualmente los valores únicos de la columna antes de continuar.
Paso 5 — Verifica el resumen antes de continuar
Al final del panel de detección, revisa la tabla resumen unificada:
| Variable | Tipo problema | Severidad | Señales | Decisión |
|---|---|---|---|---|
| nombre | Pseudo-ID | ⛔ Casi seguro | 5/5 | Excluir |
| id_expediente | Pseudo-ID | ⛔ Casi seguro | 4/5 | Excluir |
| dias_mora_actual | Leakage | ⛔ Casi seguro | 4/5 | Excluir |
| codigo_postal | Pseudo-ID | ⚠️ Posible | 2/5 | Pendiente |
Asegúrate de que no quede ninguna fila en estado “Pendiente” sin haber tomado una decisión consciente, ya sea excluir o mantener con justificación. El constructor no te bloqueará el avance, pero cualquier variable problemática que llegue sin revisar al modelo final es un riesgo que se podía haber evitado en este mismo paso.
Qué pasa si te equivocas
Si excluyes una variable por error, no hay problema, en cualquier paso posterior del constructor encontrarás un panel colapsable de “Variables excluidas” con un botón de recuperación individual para cada una. Recuperarla la devuelve al flujo desde ese punto en adelante, y la recuperación queda igualmente registrada en el log de decisiones con la justificación que introduzcas.
Esto significa que no tienes que ser excesivamente cauteloso en este paso, si una variable te genera dudas, es preferible excluirla provisionalmente y revisarla con más calma en el análisis bivariante de la fase 2, donde verás su relación real con el riesgo antes de decidir definitivamente.
Conclusiones
Tanto el constructor de scorecards del laboratorio de Analytics Lane como ScoreFlow incluyen un proceso automatizo para la detección tanto de Pseudo-IDs como Data Leakage en los conjuntos de datos. Indicando no solo la posible existencia del problema como las justificaciones de esta. Dejando al usuario la ultima decision.
Resumen del proceso
- Carga el dataset y revisa el banner de alerta inicial
- En el detector de pseudo-IDs, excluye en bloque los casos de severidad crítica (4-5 señales)
- En el detector de leakage, hazte la pregunta clave para cada variable marcada: ¿estaría disponible en el momento real de la decisión?
- Para los casos límite con pocas señales, usa criterio de negocio y documenta la decisión
- Verifica que no queda ninguna variable en estado pendiente antes de avanzar
- Si te equivocas, recupera la variable desde el panel de variables excluidas en cualquier paso posterior
Deja una respuesta