• Saltar al contenido principal
  • Skip to secondary menu
  • Saltar a la barra lateral principal
  • Saltar al pie de página
  • Inicio
  • Secciones
    • Ciencia de datos
    • Criptografía
    • Herramientas
    • Machine Learning
    • Noticias
    • Opinión
    • Productividad
    • Programación
      • JavaScript
      • Julia
      • Matlab
      • Python
      • R
  • Programación
    • JavaScript
    • Julia
    • Matlab
    • Python
    • R
  • Laboratorio
    • Estadística
      • Calculadora del Tamaño Muestral en Encuestas
      • Calculadora de estadísticos descriptivos
      • Test de normalidad
      • Calculadora de contrastes de hipotesis
      • Calculadora de tamano del efecto
      • Simulador de Regresión Lineal con Ruido
      • Descenso de gradiente
      • Visualizador de PCA
      • Visualizador de Series Temporales
      • Simulador de Regresión Logística
      • Matriz de confusión e informe de clasificación
      • Visualizador de fronteras de decisión
      • Simulador de K-Means
      • Número Óptimo de Clusters
      • Simulador de DBSCAN
      • Detector de la Ley de Benford
      • Ajuste de Curvas
      • Calculadora de Matrices
    • Probabilidad
      • Calculadora de Probabilidad de Distribuciones
      • Problema del cumpleaños
      • Calculadora de Probabilidades de Lotería
      • Simulador del Problema de Monty Hall
      • La aguja de Buffon
      • Simulador de la Estrategia Martingala
      • Simulador de Cadenas de Markov
    • Finanzas
      • Calculadora de Préstamos e Hipotecas
      • Conversor TIN ↔ TAE
      • Calculadora DCA con ajuste por inflación
      • Comparador de tarifas de luz 2.0TD
      • Calculadora XIRR con Flujos Irregulares
      • Simulador FIRE (Financial Independence, Retire Early)
      • Frontera Eficiente
    • Negocios
      • CLV
      • Scoring
    • Herramientas
      • Formateador / Minificador de JSON
      • Conversor CSV ↔ JSON
      • Consultar CSV con SQL en el navegador
      • Extractor de tickets (OCR)
      • Comparador y Formateador de Texto y JSON
      • Formateador y Tester de Expresiones Regulares
      • Inspector de JWT
      • Generador y verificador de hashes
      • Calculadora HMAC
      • Codificador / Decodificador Base64 y URL
      • Conversor de bases numericas
      • Conversor de Timestamp Unix
      • Conversor de colores
      • Generador de UUIDs
      • Editor de expresiones cron
      • Conversor de unidades
    • Juegos
      • Tres en Raya
      • Nim con Q-Learning
    • Más
      • Método D’Hondt
      • Generador de Contraseñas Seguras
  • Noticias
  • Boletín
  • Contacto
  • Tienda
    • Libros
    • Equipamiento de oficina
    • Equipamiento en movilidad

Analytics Lane

Ciencia e ingeniería de datos aplicada

  • Ciencia de datos
  • Machine Learning
  • IA Generativa
  • Python
  • Pandas
  • NumPy
  • R
  • Excel

Curiosidades

La Paradoja del Cumpleaños, o por qué no es tan raro compartir fecha de nacimiento

octubre 9, 2025 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 4 minutos

Imagínate en una sala con un grupo de personas, por ejemplo, en una oficina, un curso o una fiesta. Alguien dice: "Seguro que aquí dos personas cumplen años el mismo día". ¿Te parece poco probable? La intuición nos hace pensar que, con 365 días que tienen un año, tendría que haber muchísimas personas en el grupo para que ocurra esta coincidencia.Pero la estadística tiene … [Leer más...] acerca de La Paradoja del Cumpleaños, o por qué no es tan raro compartir fecha de nacimiento

Curiosidad: ¿Por qué usamos p < 0.05? Un umbral que cambió la historia de la ciencia
octubre 2, 2025 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 3 minutos

En casi cualquier análisis estadístico —ya sea en medicina, psicología, economía o ciencia de datos— hay un valor que aparece como juez supremo: el famoso p < 0.05.Si el valor p es menor que 0.05, decimos que el resultado es ”estadísticamente significativo”. Pero… ¿por qué ese número y no otro como 0.01 o 0.10? ¿Tiene algún fundamento teórico o fue elegido al azar?La … [Leer más...] acerca de Curiosidad: ¿Por qué usamos p < 0.05? Un umbral que cambió la historia de la ciencia

Curiosidad: La maldición de la dimensionalidad, o por qué añadir más datos puede empeorar tu modelo
septiembre 25, 2025 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 3 minutos

En el mundo del análisis de datos solemos escuchar una idea poderosa: cuantos más datos, mejor. Más variables, más columnas, más información… ¿qué podría salir mal?Pues bien, existe un fenómeno conocido como la maldición de la dimensionalidad que demuestra que añadir más dimensiones (variables) a un conjunto de datos puede complicarlo todo: desde la visualización hasta el … [Leer más...] acerca de Curiosidad: La maldición de la dimensionalidad, o por qué añadir más datos puede empeorar tu modelo

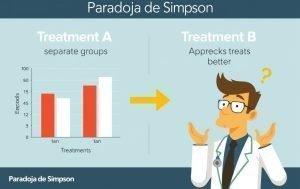
Curiosidad: La Paradoja de Simpson, o por qué no siempre debes fiarte de los promedios
septiembre 18, 2025 Por Daniel Rodríguez 2 comentarios
Tiempo de lectura: 3 minutos

En ciencia de datos y estadística, los promedios y porcentajes son herramientas fundamentales para resumir información… pero a veces pueden jugarte una mala pasada. La Paradoja de Simpson es uno de esos casos fascinantes donde los datos nos muestran una verdad a medias, o incluso directamente equivocada, dependiendo de cómo los agrupamos.Se trata de un fenómeno en el que … [Leer más...] acerca de Curiosidad: La Paradoja de Simpson, o por qué no siempre debes fiarte de los promedios

Curiosidad: La Ley de Twyman y la trampa de los datos “interesantes”
septiembre 11, 2025 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 3 minutos

En ciencia de datos, pocas cosas llaman más la atención de los científicos de datos que un valor inesperado, un pico extraño o una correlación sorprendente. Pero cuidado: según la Ley de Twyman (Twyman's law), esos datos que parecen más interesantes… ¡suelen estar mal!Formulada de manera informal por el experto en visualización Tony Twyman, esta regla no escrita … [Leer más...] acerca de Curiosidad: La Ley de Twyman y la trampa de los datos “interesantes”

Curiosidad: El origen del análisis exploratorio de datos y el papel de John Tukey

septiembre 4, 2025 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 2 minutos

Hoy en día, cuando pensamos en ciencia de datos, lo primero que nos viene a la mente suelen ser modelos predictivos complejos, redes neuronales o algoritmos de machine learning que toman decisiones casi mágicas. Sin embargo, uno de los pilares más importantes de esta disciplina moderna tiene raíces mucho más sencillas y humanas: observar, explorar y dejar que los datos hablen … [Leer más...] acerca de Curiosidad: El origen del análisis exploratorio de datos y el papel de John Tukey

Diferencias entre los errores 401 y 403 del estándar HTTP

noviembre 29, 2023 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 3 minutos

Al navegar por la web o interactuar con una API es probable encontrarse con mensajes de error como "401 Unauthorized" o "403 Forbidden". A primera vista, estos errores pueden parecer lo mismo, ya que ambos indican la existencia de un problema de permisos para acceder a un recurso. Pero no lo son, existen diferencias clave entre ellos. En esta entrada, se explicará cuándo y por … [Leer más...] acerca de Diferencias entre los errores 401 y 403 del estándar HTTP

Curiosidad: El uso del número 42 para fijar la semilla

julio 7, 2023 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 2 minutos

Si habitualmente revisáis el código de otros programadores o científicos de datos, algo que es muy recomendable, seguramente os habréis encontrado con el uso del número 42 como semilla. Pero ¿por qué es tan habitual usar el número 42 para fijar la semilla en lugar de otros que podrían ser más intuitivos como 0 o 1?Origen del número 42 para fijar la semillaEl uso tan … [Leer más...] acerca de Curiosidad: El uso del número 42 para fijar la semilla

  • « Ir a la página anterior
  • Página 1
  • Página 2

Barra lateral principal

Suscríbete a nuestro boletín

Suscríbete al boletín semanal para estar al día de todas las publicaciones.

Política de Privacidad

Analytics Lane en redes sociales

  • Amazon
  • Bluesky
  • Facebook
  • GitHub
  • Instagram
  • Mastodon
  • Pinterest
  • RSS
  • Telegram
  • Tumblr
  • Twitter
  • YouTube

Publicidad

Entradas recientes

Curiosidad: “Wi-Fi” no significa “Wireless Fidelity”

noviembre 12, 2026 Por Daniel Rodríguez

Shallow copy vs Deep copy en Python: la mutación inesperada

noviembre 10, 2026 Por Daniel Rodríguez

Cómo Saber si una Diferencia Significativa es Importante

noviembre 5, 2026 Por Daniel Rodríguez

Publicidad

Es tendencia

  • ¿Puede la inteligencia artificial ser creativa? [Mitos de la Inteligencia Artificial 3] publicado el julio 2, 2024 | en Opinión
  • Riesgo relativo vs riesgo absoluto: la trampa de los titulares alarmistas publicado el enero 29, 2026 | en Opinión
  • Calcular la moda en un vector de NumPy publicado el septiembre 26, 2022 | en Python
  • Compra on-line Tasa de retención de clientes para CLV publicado el junio 6, 2018 | en Ciencia de datos
  • Codificación JSON Archivos JSON con Python: lectura y escritura publicado el julio 16, 2018 | en Python

Publicidad

Lo mejor valorado

4.9 (24)

Seleccionar filas y columnas en Pandas con iloc y loc

4.6 (16)

Archivos JSON con Python: lectura y escritura

4.4 (14)

Ordenación de diccionarios en Python mediante clave o valor

4.7 (13)

Operaciones de filtrado de DataFrame con Pandas en base a los valores de las columnas

4.1 (11)

Aplicar el método D’Hondt en Excel

Comentarios recientes

  • Daniel Rodríguez en Curiosidad: La Paradoja de Simpson, o por qué no siempre debes fiarte de los promedios
  • Hatepi en Curiosidad: La Paradoja de Simpson, o por qué no siempre debes fiarte de los promedios
  • Daniel Rodríguez en Los récords con asterisco, o la épica del titular sin contexto – El bestiario de los indicadores económicos absurdos (parte 8 y final)
  • Juan en Los récords con asterisco, o la épica del titular sin contexto – El bestiario de los indicadores económicos absurdos (parte 8 y final)
  • bif en JSON en bases de datos: cuándo es buena idea y cuándo no

Publicidad


Footer

Analytics Lane

  • Acerca de Analytics Lane
  • Boletín de noticias
  • Contacto
  • Libros
  • Lo más popular
  • Noticias
  • Tienda
  • Tiendas afiliadas

Secciones

  • Ciencia de datos
  • Criptografía
  • Herramientas
  • Machine Learning
  • Opinión
  • Productividad
  • Programación
  • Reseñas

Sobre de Analytics Lane

En Analytics Lane tratamos de explicar los principales conceptos de la ciencia e ingeniería de datos con un enfoque práctico. Los principales temas tratados son ciencia de datos, ingeniería de datos, inteligencia artificial, machine learning, deep learning y criptografía. Además, también se habla de los principales lenguajes de programación y herramientas utilizadas por los científicos e ingenieros de datos.

Copyright © 2018-2026 Analytics Lane ·Términos y condiciones ·Política de Cookies ·Política de Privacidad ·Herramientas de privacidad ·Contacto