• Saltar al contenido principal
  • Skip to secondary menu
  • Saltar a la barra lateral principal
  • Saltar al pie de página
  • Inicio
  • Secciones
    • Ciencia de datos
    • Criptografía
    • Herramientas
    • Machine Learning
    • Noticias
    • Opinión
    • Productividad
    • Programación
      • JavaScript
      • Julia
      • Matlab
      • Python
      • R
  • Programación
    • JavaScript
    • Julia
    • Matlab
    • Python
    • R
  • Laboratorio
    • Estadística
      • Calculadora del Tamaño Muestral en Encuestas
      • Calculadora de estadísticos descriptivos
      • Test de normalidad
      • Calculadora de contrastes de hipotesis
      • Calculadora de tamano del efecto
      • Simulador de Regresión Lineal con Ruido
      • Visualizador de PCA
      • Visualizador de Series Temporales
      • Simulador de Regresión Logística
      • Simulador de K-Means
      • Simulador de DBSCAN
      • Detector de la Ley de Benford
      • Ajuste de Curvas
      • Calculadora de Matrices
    • Probabilidad
      • Calculadora de Probabilidad de Distribuciones
      • Calculadora de Probabilidades de Lotería
      • Simulador del Problema de Monty Hall
      • Simulador de la Estrategia Martingala
    • Finanzas
      • Calculadora de Préstamos e Hipotecas
      • Conversor TIN ↔ TAE
      • Calculadora DCA con ajuste por inflación
      • Calculadora XIRR con Flujos Irregulares
      • Simulador FIRE (Financial Independence, Retire Early)
    • Negocios
      • CLV
      • Scoring
    • Herramientas
      • Formateador / Minificador de JSON
      • Conversor CSV ↔ JSON
      • Comparador y Formateador de Texto y JSON
      • Formateador y Tester de Expresiones Regulares
      • Inspector de JWT
      • Generador y verificador de hashes
      • Codificador / Decodificador Base64 y URL
      • Conversor de bases numericas
      • Conversor de Timestamp Unix
      • Conversor de colores
      • Generador de UUIDs
    • Juegos
      • Tres en Raya
      • Nim con Q-Learning
    • Más
      • Método D’Hondt
      • Generador de Contraseñas Seguras
  • Noticias
  • Boletín
  • Contacto
  • Tienda
    • Libros
    • Equipamiento de oficina
    • Equipamiento en movilidad

Analytics Lane

Ciencia e ingeniería de datos aplicada

  • Ciencia de datos
  • Machine Learning
  • IA Generativa
  • Python
  • Pandas
  • NumPy
  • R
  • Excel

Uso del método df.describe() de Pandas para el análisis de datos

abril 1, 2024 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 3 minutos

Pandas es la biblioteca de referencia para el análisis de datos en Python. Lo que es debido a ofrecer una gran cantidad de funciones para la manipulación y análisis altamente eficientes y fáciles de utilizar. Posiblemente uno de los mejores ejemplos de estos es el método df.describe(). Una función que produce un resumen estadístico del contenido de un DataFrame que permite … [Leer más...] acerca de Uso del método df.describe() de Pandas para el análisis de datos

Semana sin publicaciones
marzo 25, 2024 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: < 1 minuto

Analytics Lane

Como es habitual durante esta semana no habrá nuevas publicaciones en Analytics Lane, pero no os preocupes ya que volveremos con nuevas publicaciones el lunes 1 de abril.Quiero recordaros que para estar al día de todas las publicaciones y no perderos nada disponéis de varios medios. El boletín de noticias se envía todos los lunes, para recibirlo os podéis daros de alta … [Leer más...] acerca de Semana sin publicaciones

Normalización de datos: Maximizando el rendimiento de los modelos de Aprendizaje Automático

marzo 22, 2024 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 6 minutos

La preparación de los datos es una parte clave del éxito de los modelos de aprendizaje automático o Machine Learning. Siendo una parte fundamental del trabajo para garantizar que los modelos puedan aprender de manera efectiva y eficiente. Una de las técnicas más sencillas y utilizadas durante la fase de preparación de los datos es la normalización de datos. En esta entrada, se … [Leer más...] acerca de Normalización de datos: Maximizando el rendimiento de los modelos de Aprendizaje Automático

Herramienta para evaluar el rendimiento de código JavaScript
marzo 20, 2024 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 3 minutos

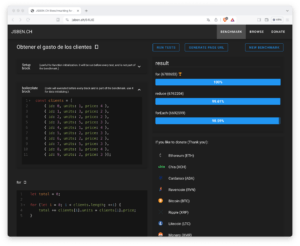
Captura de pantalla de la aplicación jsben para comparar el rendimiento de bloques de código JavaScript con un ejemplo

En JavaScript es habitual que exista más de una forma para implementar la misma tarea. Pero no todas son igual de rápidas, eficaces ni igual de fáciles de leer. La mejor opción para seleccionar el método más adecuado es realizar un benchmark en el que se compara el rendimiento de cada una de las opciones con un conjunto de datos. Algo que se ha hecho anteriormente en el blog … [Leer más...] acerca de Herramienta para evaluar el rendimiento de código JavaScript

Inclusión de valores y variables en las f-strings de Python
marzo 18, 2024 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 3 minutos

Las f-strings, o formatted string literals, son una característica introducida en Python 3.6 con la que se simplifica la tarea de dar formato a las cadenas de texto. Facilitando interpolar variables y expresiones dentro de las cadenas de texto. Sin embargo, ¿sabías que las f-strings tienen una función especial que permite incluir tanto el nombre de la variable como su valor en … [Leer más...] acerca de Inclusión de valores y variables en las f-strings de Python

One-Class SVM: Detección de anomalías con máquinas de vector soporte
marzo 15, 2024 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 6 minutos

Gráfica con los datos y las anomalías detectadas con OneClass SVM

La detección de anomalías es una de las aplicaciones del aprendizaje no supervisado más utilizadas. Siendo una técnica que se emplea en casos tan diferentes como la detección de ataques cibernéticos, la detección de problemas de salud o la identificación de aplicaciones fraudulentas en servicios financieros o seguros. En todos los casos, identificar anomalías requiere localizar … [Leer más...] acerca de One-Class SVM: Detección de anomalías con máquinas de vector soporte

900 publicaciones en Analytics Lane

marzo 14, 2024 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 2 minutos

Analytics Lane

Ayer se publicó la entrada 900 de en la historia de Analytics Lane. Este logro representa un paso significativo que fortalece aún más el proyecto de divulgación y formación. Desde nuestra primera publicación el 2 de mayo de 2018, he estado compartiendo de manera constante recursos sobre ciencia de datos, lenguajes de programación, herramientas y sus aplicaciones en español en … [Leer más...] acerca de 900 publicaciones en Analytics Lane

Guía para recuperar commits perdidos en Git

marzo 13, 2024 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 3 minutos

Perder commits en Git es una experiencia desagradable. Después de invertir tiempo y esfuerzo en el código, ver que este no está en el repositorio es frustrante y estresante. Algo que sé por experiencia propia. Sin embargo, en Git existen herramientas para restaurar los commits perdidos y recuperar el trabajo. Generalmente, aunque no se vean los commits, lo normal es que estos … [Leer más...] acerca de Guía para recuperar commits perdidos en Git

Introducción a SQLite 3 en Python
marzo 11, 2024 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 8 minutos

Las bases de datos son una parte clave de los programas que necesitan persistir información. Para pequeñas aplicaciones, donde solo se guardan unos pocos registros, recurrir a una gran base de datos relacional como pueden ser PostgreSQL, MariaDB o SQL Server no es una buena opción debido que pueden ser difíciles de configurar. En estos casos una mejor opción es un sistema … [Leer más...] acerca de Introducción a SQLite 3 en Python

Diferencia entre R2 y R2 ajustado en modelos de regresión

marzo 8, 2024 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 3 minutos

Usar la métrica adecuada es clave para comprender cuán bien se ajusta un modelo a los datos. En los modelos de regresión existen dos métricas usadas habitualmente que son el coeficiente de determinación (R2) y el coeficiente de determinación ajustado (R2 ajustado). Aunque ambos ofrecen buena información de la calidad del ajuste del modelo a los datos reales, difieren … [Leer más...] acerca de Diferencia entre R2 y R2 ajustado en modelos de regresión

Actualización de Seguridad en el repositorio expresslanets
marzo 7, 2024 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: < 1 minuto

Noticias

Recientemente, he recibido un aviso crítico por parte de GitHub respecto a uno de los repositorios de Analytics Lane. En concreto, el repositorio expresslanets, se ha encontrado que una dependencia presentaba una vulnerabilidad conocida. Aunque es un proyecto básicamente pedagógico, ignorar advertencias de seguridad como estas no es una opción responsable. Los fallos de … [Leer más...] acerca de Actualización de Seguridad en el repositorio expresslanets

Descubrimiento de modelos maliciosos en Hugging Face

marzo 7, 2024 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: < 1 minuto

Noticias

Recientemente se han descubierto que más de 100 modelos maliciosos de inteligencia artificial (IA) y aprendizaje automático (ML) están presentes en la plataforma de Hugging Face. Estos modelos representan una amenaza significativa, ya que pueden ejecutar código malicioso al cargar archivos pickle, permitiendo a los atacantes tomar el control de las máquinas comprometidas.El … [Leer más...] acerca de Descubrimiento de modelos maliciosos en Hugging Face

  • « Ir a la página anterior
  • Página 1
  • Páginas intermedias omitidas …
  • Página 28
  • Página 29
  • Página 30
  • Página 31
  • Página 32
  • Páginas intermedias omitidas …
  • Página 105
  • Ir a la página siguiente »

Barra lateral principal

Suscríbete a nuestro boletín

Suscríbete al boletín semanal para estar al día de todas las publicaciones.

Política de Privacidad

Analytics Lane en redes sociales

  • Amazon
  • Bluesky
  • Facebook
  • GitHub
  • Instagram
  • Mastodon
  • Pinterest
  • RSS
  • Telegram
  • Tumblr
  • Twitter
  • YouTube

Publicidad

Entradas recientes

Por qué migrar tus proyectos TypeScript a ES Modules en 2026

septiembre 17, 2026 Por Daniel Rodríguez

Método del codo: interpretación correcta y limitaciones

septiembre 15, 2026 Por Daniel Rodríguez

Errores comunes al interpretar resultados estadísticos

septiembre 10, 2026 Por Daniel Rodríguez

Publicidad

Es tendencia

  • Curiosidad: La Paradoja de Simpson, o por qué no siempre debes fiarte de los promedios publicado el septiembre 18, 2025 | en Ciencia de datos, Opinión
  • Método del codo (Elbow method) para seleccionar el número óptimo de clústeres en K-means publicado el junio 9, 2023 | en Ciencia de datos
  • Operaciones de filtrado de DataFrame con Pandas en base a los valores de las columnas publicado el mayo 10, 2019 | en Python
  • Gini, KS y AUC: Cómo Medir la Calidad de un Modelo de Credit Scoring publicado el agosto 18, 2026 | en Ciencia de datos
  • Creación de gráficos de barras y gráficos de columnas con Seaborn publicado el julio 18, 2023 | en Python

Publicidad

Lo mejor valorado

4.9 (24)

Seleccionar filas y columnas en Pandas con iloc y loc

4.6 (16)

Archivos JSON con Python: lectura y escritura

4.4 (14)

Ordenación de diccionarios en Python mediante clave o valor

4.7 (13)

Operaciones de filtrado de DataFrame con Pandas en base a los valores de las columnas

4.1 (11)

Aplicar el método D’Hondt en Excel

Comentarios recientes

  • Daniel Rodríguez en Curiosidad: La Paradoja de Simpson, o por qué no siempre debes fiarte de los promedios
  • Hatepi en Curiosidad: La Paradoja de Simpson, o por qué no siempre debes fiarte de los promedios
  • Daniel Rodríguez en Los récords con asterisco, o la épica del titular sin contexto – El bestiario de los indicadores económicos absurdos (parte 8 y final)
  • Juan en Los récords con asterisco, o la épica del titular sin contexto – El bestiario de los indicadores económicos absurdos (parte 8 y final)
  • bif en JSON en bases de datos: cuándo es buena idea y cuándo no

Publicidad


Footer

Analytics Lane

  • Acerca de Analytics Lane
  • Boletín de noticias
  • Contacto
  • Libros
  • Lo más popular
  • Noticias
  • Tienda
  • Tiendas afiliadas

Secciones

  • Ciencia de datos
  • Criptografía
  • Herramientas
  • Machine Learning
  • Opinión
  • Productividad
  • Programación
  • Reseñas

Sobre de Analytics Lane

En Analytics Lane tratamos de explicar los principales conceptos de la ciencia e ingeniería de datos con un enfoque práctico. Los principales temas tratados son ciencia de datos, ingeniería de datos, inteligencia artificial, machine learning, deep learning y criptografía. Además, también se habla de los principales lenguajes de programación y herramientas utilizadas por los científicos e ingenieros de datos.

Copyright © 2018-2026 Analytics Lane ·Términos y condiciones ·Política de Cookies ·Política de Privacidad ·Herramientas de privacidad ·Contacto