• Saltar al contenido principal
  • Skip to secondary menu
  • Saltar a la barra lateral principal
  • Saltar al pie de página
  • Inicio
  • Secciones
    • Ciencia de datos
    • Criptografía
    • Herramientas
    • Machine Learning
    • Noticias
    • Opinión
    • Productividad
    • Programación
      • JavaScript
      • Julia
      • Matlab
      • Python
      • R
  • Programación
    • JavaScript
    • Julia
    • Matlab
    • Python
    • R
  • Laboratorio
    • Estadística
      • Calculadora del Tamaño Muestral en Encuestas
      • Calculadora de estadísticos descriptivos
      • Test de normalidad
      • Calculadora de contrastes de hipotesis
      • Calculadora de tamano del efecto
      • Simulador de Regresión Lineal con Ruido
      • Visualizador de PCA
      • Visualizador de Series Temporales
      • Simulador de Regresión Logística
      • Simulador de K-Means
      • Simulador de DBSCAN
      • Detector de la Ley de Benford
      • Ajuste de Curvas
      • Calculadora de Matrices
    • Probabilidad
      • Calculadora de Probabilidad de Distribuciones
      • Calculadora de Probabilidades de Lotería
      • Simulador del Problema de Monty Hall
      • Simulador de la Estrategia Martingala
    • Finanzas
      • Calculadora de Préstamos e Hipotecas
      • Conversor TIN ↔ TAE
      • Calculadora DCA con ajuste por inflación
      • Calculadora XIRR con Flujos Irregulares
      • Simulador FIRE (Financial Independence, Retire Early)
    • Negocios
      • CLV
      • Scoring
    • Herramientas
      • Formateador / Minificador de JSON
      • Conversor CSV ↔ JSON
      • Comparador y Formateador de Texto y JSON
      • Formateador y Tester de Expresiones Regulares
      • Inspector de JWT
      • Generador y verificador de hashes
      • Codificador / Decodificador Base64 y URL
      • Conversor de bases numericas
      • Conversor de Timestamp Unix
      • Conversor de colores
      • Generador de UUIDs
    • Juegos
      • Tres en Raya
      • Nim con Q-Learning
    • Más
      • Método D’Hondt
      • Generador de Contraseñas Seguras
  • Noticias
  • Boletín
  • Contacto
  • Tienda
    • Libros
    • Equipamiento de oficina
    • Equipamiento en movilidad

Analytics Lane

Ciencia e ingeniería de datos aplicada

  • Ciencia de datos
  • Machine Learning
  • IA Generativa
  • Python
  • Pandas
  • NumPy
  • R
  • Excel

Integración continua para la ciencia de datos

enero 21, 2022 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 5 minutos

En los grandes proyectos de ciencia de datos aparecen problemas similares a los de los grandes desarrollos de software. Uno de ellos es la necesidad de integrar en una única solución el trabajo de todos los miembros del equipo. Para ello una de las técnicas más empleadas en desarrollo de software es la integración y la entrega continuas (CI/CD). Veamos a continuación algunas de … [Leer más...] acerca de Integración continua para la ciencia de datos

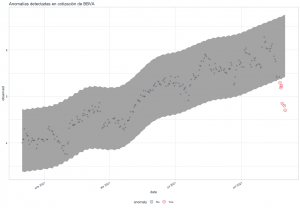
Detección de anomalías en series temporales
enero 19, 2022 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 3 minutos

Anomalías detectadas en cotización de BBVA detectadas con anomalize

La detección de anomalías es un campo del aprendizaje automático con múltiples aplicaciones prácticas. Poder identificar automáticamente los datos que son atípicos para una variable permite lanzar alarmas para comprobar la existencia temprana de algún problema. Pudiendo actuar en consecuencia y minimizar las posibles consecuencias. Recientemente he descubierto un paquete de R, … [Leer más...] acerca de Detección de anomalías en series temporales

El nuevo switch en Python 3.10

enero 17, 2022 Por Daniel Rodríguez 3 comentarios
Tiempo de lectura: 3 minutos

Posiblemente una de las novedades más interesantes que ha traído la versión 3.10 de Python es la incorporación de un nuevo mecanismo de control de flujo Match-Case. Mecanismos que es habitual en otros lenguajes de alto nivel y que en la mayoría de los casos se conoce como switch-case. Un mecanismo que, a diferencia de Python, ya se encontraba implementado hace tiempo en otros … [Leer más...] acerca de El nuevo switch en Python 3.10

Diferencias entre Hard y Soft Clustering
enero 14, 2022 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 3 minutos

El análisis de clustering o análisis de grupo es una de las técnicas más populares dentro del aprendizaje no supervisado. Cuando se dispone de un conjunto de datos sin etiquetar, esto es no se tiene un valor o etiqueta asociado a cada registro, se puede utilizar el análisis de clustering para agrupar los elementos que son similares entres sí y separa aquellos que son … [Leer más...] acerca de Diferencias entre Hard y Soft Clustering

Usar entornos de Python en VS Code

enero 12, 2022 Por Daniel Rodríguez 4 comentarios
Tiempo de lectura: 3 minutos

Al trabajar en diferentes proyectos con Python es habitual encontrarse con el problema de que tanto código como paquetes presentan problemas de compatibilidad con ciertas versiones del intérprete. Por lo que es necesario ejecutar cada proyecto en una versión del intérprete de Python diferente. Lo que se puede conseguir usando varios ordenadores, instalando en cada uno una … [Leer más...] acerca de Usar entornos de Python en VS Code

Balance de 2021 en Analytics Lane
enero 10, 2022 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 3 minutos

Analytics Lane

Como ya es tradicional, en esta, la primera publicación del año, realizaré un balance de las publicaciones más visitadas durante el año pasado, así como las procedencia de las visitas por país. Un análisis que es de interés para conocer mejor a la audiencia del blog. Siendo el año 2021 excelente para Analytics Lane, en el que el número de visitas ha aumentado más de un 35% … [Leer más...] acerca de Balance de 2021 en Analytics Lane

Feliz Navidad y próspero año 2022

diciembre 24, 2021 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: < 1 minuto

Analytics Lane

Como todos los años, quería dedicar esta entrada para desearos Feliz Navidad y próspero año 2022 a todos los lectores de Analytics Lane. Un año en el que he apurado la felicitación hasta el último día.Al igual que en el año anterior, durante estas fiestas no se van a publicar nuevas entradas en el blog. Retomando la rutina de publicaciones el lunes 10 de enero del 2022 con … [Leer más...] acerca de Feliz Navidad y próspero año 2022

Diferencias entre Apache Arrow y Parquet
diciembre 24, 2021 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 3 minutos

Apache Arrow y Parquet son dos formatos modernos para con los que es posible conseguir archivos más pequeños que CSV, además de unos menores tiempos de lectura y escritura. Veamos a continuación las diferencias que existen entre Apache Arrow y Parquet.Apache ArrowApache Arrow es una biblioteca, disponible para múltiples lenguajes de programación, que proporciona … [Leer más...] acerca de Diferencias entre Apache Arrow y Parquet

El gordo del sorteo de Navidad no ha sido el 72850

diciembre 23, 2021 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 3 minutos

El pasado sábado publiqué una entrada, básicamente en tono de humor, en el que intentaba predecir mediante el uso de series temporales el resultado del Sorteo Extraordinario de Navidad de la Lotería Nacional. Un sorteo de lotería muy popular en España que para muchos supone el comienzo de las fiestas navideñas. La idea de usar una serie temporal para predecir no tenía sentido, … [Leer más...] acerca de El gordo del sorteo de Navidad no ha sido el 72850

Archivos Parquet en Julia
diciembre 22, 2021 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 2 minutos

En una publicación reciente se ha visto las ventajas que ofrece el uso de archivos Parquet frente a CSV o Feather en Pandas. Consiguiendo guardar un conjunto de datos aleatorios en un archivo un 10% más pequeño que CSV con compresión hasta 100 veces más rápido. Algo que, en algunos puntos, mejora el rendimiento de Feather. Veamos como se puede trabajar con archivos Parquet en … [Leer más...] acerca de Archivos Parquet en Julia

Uso de Parquet para guardar los conjuntos de datos de forma eficiente en Pandas
diciembre 20, 2021 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 5 minutos

Los formatos de archivo para el intercambio de datos más populares actualmente son CSV y Microsoft Excel. Resultando ambos poco eficientes a la hora trabajar con grandes conjuntos de datos. CSV es un formato basado en archivos de texto plano, lo que permite su edición con cualquier editor de texto, sin la necesidad de emplear un programa específico. Aunque esto también se … [Leer más...] acerca de Uso de Parquet para guardar los conjuntos de datos de forma eficiente en Pandas

Predecir el premio en la Lotería de Navidad con series temporales

diciembre 18, 2021 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 5 minutos

El Sorteo Extraordinario de Navidad de la Lotería Nacional es una tradición que se celebra en España desde hace más de dos siglos. Un sorteo que se celebra todos los años el 22 de diciembre y, para mucha gente, representa el comienzo de las celebraciones de Navidad. Al acercarse las fechas de Navidad, un amigo me preguntó si sería posible predecir el premio en la Lotería de … [Leer más...] acerca de Predecir el premio en la Lotería de Navidad con series temporales

  • « Ir a la página anterior
  • Página 1
  • Páginas intermedias omitidas …
  • Página 55
  • Página 56
  • Página 57
  • Página 58
  • Página 59
  • Páginas intermedias omitidas …
  • Página 105
  • Ir a la página siguiente »

Barra lateral principal

Suscríbete a nuestro boletín

Suscríbete al boletín semanal para estar al día de todas las publicaciones.

Política de Privacidad

Analytics Lane en redes sociales

  • Amazon
  • Bluesky
  • Facebook
  • GitHub
  • Instagram
  • Mastodon
  • Pinterest
  • RSS
  • Telegram
  • Tumblr
  • Twitter
  • YouTube

Publicidad

Entradas recientes

Por qué migrar tus proyectos TypeScript a ES Modules en 2026

septiembre 17, 2026 Por Daniel Rodríguez

Método del codo: interpretación correcta y limitaciones

septiembre 15, 2026 Por Daniel Rodríguez

Errores comunes al interpretar resultados estadísticos

septiembre 10, 2026 Por Daniel Rodríguez

Publicidad

Es tendencia

  • Curiosidad: La Paradoja de Simpson, o por qué no siempre debes fiarte de los promedios publicado el septiembre 18, 2025 | en Ciencia de datos, Opinión
  • Uso de Parquet para guardar los conjuntos de datos de forma eficiente en Pandas publicado el diciembre 20, 2021 | en Python
  • Matrices dispersas (“Sparse Matrix”) publicado el octubre 21, 2019 | en Ciencia de datos
  • Mostrar barra de progreso en Jupyter publicado el febrero 17, 2020 | en Python
  • Gráficos de barras en Matplotlib publicado el julio 5, 2022 | en Python

Publicidad

Lo mejor valorado

4.9 (24)

Seleccionar filas y columnas en Pandas con iloc y loc

4.6 (16)

Archivos JSON con Python: lectura y escritura

4.4 (14)

Ordenación de diccionarios en Python mediante clave o valor

4.7 (13)

Operaciones de filtrado de DataFrame con Pandas en base a los valores de las columnas

4.1 (11)

Aplicar el método D’Hondt en Excel

Comentarios recientes

  • Daniel Rodríguez en Curiosidad: La Paradoja de Simpson, o por qué no siempre debes fiarte de los promedios
  • Hatepi en Curiosidad: La Paradoja de Simpson, o por qué no siempre debes fiarte de los promedios
  • Daniel Rodríguez en Los récords con asterisco, o la épica del titular sin contexto – El bestiario de los indicadores económicos absurdos (parte 8 y final)
  • Juan en Los récords con asterisco, o la épica del titular sin contexto – El bestiario de los indicadores económicos absurdos (parte 8 y final)
  • bif en JSON en bases de datos: cuándo es buena idea y cuándo no

Publicidad


Footer

Analytics Lane

  • Acerca de Analytics Lane
  • Boletín de noticias
  • Contacto
  • Libros
  • Lo más popular
  • Noticias
  • Tienda
  • Tiendas afiliadas

Secciones

  • Ciencia de datos
  • Criptografía
  • Herramientas
  • Machine Learning
  • Opinión
  • Productividad
  • Programación
  • Reseñas

Sobre de Analytics Lane

En Analytics Lane tratamos de explicar los principales conceptos de la ciencia e ingeniería de datos con un enfoque práctico. Los principales temas tratados son ciencia de datos, ingeniería de datos, inteligencia artificial, machine learning, deep learning y criptografía. Además, también se habla de los principales lenguajes de programación y herramientas utilizadas por los científicos e ingenieros de datos.

Copyright © 2018-2026 Analytics Lane ·Términos y condiciones ·Política de Cookies ·Política de Privacidad ·Herramientas de privacidad ·Contacto