• Saltar al contenido principal
  • Skip to secondary menu
  • Saltar a la barra lateral principal
  • Saltar al pie de página
  • Inicio
  • Secciones
    • Ciencia de datos
    • Criptografía
    • Herramientas
    • Machine Learning
    • Noticias
    • Opinión
    • Productividad
    • Programación
      • JavaScript
      • Julia
      • Matlab
      • Python
      • R
  • Programación
    • JavaScript
    • Julia
    • Matlab
    • Python
    • R
  • Laboratorio
    • Estadística
      • Calculadora del Tamaño Muestral en Encuestas
      • Calculadora de estadísticos descriptivos
      • Test de normalidad
      • Calculadora de contrastes de hipotesis
      • Calculadora de tamano del efecto
      • Simulador de Regresión Lineal con Ruido
      • Visualizador de PCA
      • Visualizador de Series Temporales
      • Simulador de Regresión Logística
      • Simulador de K-Means
      • Simulador de DBSCAN
      • Detector de la Ley de Benford
      • Ajuste de Curvas
      • Calculadora de Matrices
    • Probabilidad
      • Calculadora de Probabilidad de Distribuciones
      • Calculadora de Probabilidades de Lotería
      • Simulador del Problema de Monty Hall
      • Simulador de la Estrategia Martingala
    • Finanzas
      • Calculadora de Préstamos e Hipotecas
      • Conversor TIN ↔ TAE
      • Calculadora DCA con ajuste por inflación
      • Calculadora XIRR con Flujos Irregulares
      • Simulador FIRE (Financial Independence, Retire Early)
    • Negocios
      • CLV
      • Scoring
    • Herramientas
      • Formateador / Minificador de JSON
      • Conversor CSV ↔ JSON
      • Comparador y Formateador de Texto y JSON
      • Formateador y Tester de Expresiones Regulares
      • Inspector de JWT
      • Generador y verificador de hashes
      • Codificador / Decodificador Base64 y URL
      • Conversor de bases numericas
      • Conversor de Timestamp Unix
      • Conversor de colores
      • Generador de UUIDs
    • Juegos
      • Tres en Raya
      • Nim con Q-Learning
    • Más
      • Método D’Hondt
      • Generador de Contraseñas Seguras
  • Noticias
  • Boletín
  • Contacto
  • Tienda
    • Libros
    • Equipamiento de oficina
    • Equipamiento en movilidad

Analytics Lane

Ciencia e ingeniería de datos aplicada

  • Ciencia de datos
  • Machine Learning
  • IA Generativa
  • Python
  • Pandas
  • NumPy
  • R
  • Excel

Python

Python es un lenguaje de programación interpretado con una filosofía basada en la legibilidad del código. Un lenguaje que gracias posee un gran ecosistema de librerías para la ciencia de datos. Por lo que es uno de los más populares en la actualidad entre los científicos de datos. Además, es uno de los lenguajes más deseados y adorados por los programadores según las encuestas de Stack Overflow.

Python es un lenguaje de programación interpretado de propósito general que obliga al uso de una sintaxis clara, gracias a la cual el código es altamente legible. Siendo un lenguaje potente y fácil de aprender. Además, permite utilizar múltiples paradigmas de programación. Lo que permite usar desde programación orientada a objetos, pasando por programación imperativa o funcional.

Los paquetes de Python más utilizados por los científicos son:

  • NumPy: permite el tratamiento de datos basados en matrices,
  • Pandas: ideal para la manipulación de datos heterogéneos mediante objetos DataFrame,
  • SciPy: implementa tareas habituales en computación científica,
  • Matplotlib: facilita la visualización de datos y scikit-learn creación de modelos de aprendizaje automático.

Las publicaciones de esta sección versan sobre estas librerías y las bases del lenguaje.

Representar los criterios de selección en árboles de decisión

junio 3, 2022 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 3 minutos

La representación de árboles de decisión es un tema del que ya se ha publicado con antelación en el blog. En su momento de ha visto los pasos necesarios para generar representaciones gráficas y de texto con las librerías PyDotPlus y Scikit-Learn. Aunque también existen otras librerías como dtreeviz, la que veremos hoy. Una librería con la que es posible representar los … [Leer más...] acerca de Representar los criterios de selección en árboles de decisión

Truco: reemplazar los valores NaN en los DataFrame Pandas

mayo 30, 2022 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 2 minutos

La existencia de valores NaN es un conjunto de datos puede ser una molestia ya que no es posible realizar muchas operaciones con ellos. Por eso conocer un método para reemplazar los valores NaN en los DataFrame por cualquier otro puede solucionar algunos problemas. Afortunadamente para ello existe el método fillna() en Pandas, con el que se puede reemplazar todas las … [Leer más...] acerca de Truco: reemplazar los valores NaN en los DataFrame Pandas

Obtener el valor máximo de un diccionario en Python

mayo 23, 2022 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 3 minutos

Los diccionarios son estructuras de datos con las que es posible almacenar colecciones de datos y acceder a ellos mediante una clave, no el índice en la colección. Algo que los hace tremendamente útiles para múltiples aplicaciones. Aunque algunas tareas como obtener la clave o el elemento cuyo valor sea el máximo o mínimo del conjunto puede ser algo complicado. Veamos las … [Leer más...] acerca de Obtener el valor máximo de un diccionario en Python

Creación de un EXE desde un archivo Python en Windows
mayo 16, 2022 Por Daniel Rodríguez 3 comentarios
Tiempo de lectura: 5 minutos

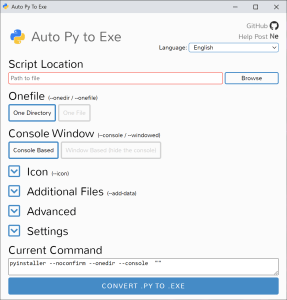
La aplicación Auto Py to Exe

Con Python se pueden crear grandes aplicaciones informáticas con las que solucionar múltiples problemas. Aunque hacerlas llegar a usuarios finales con pocos conocimientos puede ser complicado. Hay que enviar una carpeta con todos los archivos del proyecto, instalar la versión correcta de Python, las dependencias del proyecto y ejecutar desde la línea de comandos el programa. … [Leer más...] acerca de Creación de un EXE desde un archivo Python en Windows

Creación básicas de GUI en Python con PySimpleGUI

mayo 9, 2022 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 6 minutos

Calculadora básica implementada con PySimpleGUI

Una de las soluciones más sencillas para la creación de aplicaciones con una Interfaz Gráfica de Usuario (GUI del inglés Graphical User Interface) en Python es PySimpleGUI. Librería con la que es posible desarrollar GUI funcionales para Windows, macOS y Linux en pocas líneas de código. Con lo que se puede estar seguro de que los desarrollos realizados serán fácilmente portables … [Leer más...] acerca de Creación básicas de GUI en Python con PySimpleGUI

Uso de Pandas Query para filtrar datos de forma sencilla
mayo 2, 2022 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 6 minutos

En los DataFrames de Pandas se puede emplear vectores lógicos para seleccionar las filas que cumplen una o varias condiciones. Algo que se puede utilizar para realizar operaciones de filtrado de datos. Aunque esta característica es muy poderosa, existe otra opción con la que generalmente se puede conseguir filtrar los datos de una manera mucho más sencilla: Pandas Query. Un … [Leer más...] acerca de Uso de Pandas Query para filtrar datos de forma sencilla

Cambiar variables de entorno desde Jupyter Notebook
abril 27, 2022 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 2 minutos

En ciertas ocasiones puede ser necesario modificar alguna variable de entorno para poder ejecutar cierto código en un Notebook. Cuando el cambio debe ser permanente este se puede hacer en la Configuración avanzada del sistema en Windows o en los archivos de configuración del Shell en UNIX. Por otro lado, para cambios temporales se puede hacer en la terminal, pero esto obliga a … [Leer más...] acerca de Cambiar variables de entorno desde Jupyter Notebook

Importar automáticamente las dependencias en Python con una línea
abril 25, 2022 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 2 minutos

Python es uno de los mejores entornos de trabajo que existen actualmente para los científicos de datos. Existen múltiples librerías con las que realizar de una forma sencilla y eficiente una gran cantidad de tareas, como pueden ser NumPy, Pandas, Matplotlib, Seaborn o Scikit-Learn. Aunque la importación de todas las dependencias necesarias en un proyecto puede llegar a ser una … [Leer más...] acerca de Importar automáticamente las dependencias en Python con una línea

Depuración de código en Python con Snoop
abril 18, 2022 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 5 minutos

La depuración es una de las fases más importantes dentro del proceso de desarrollo. Aunque también suele ser una de las más frustrantes. Para solucionar un problema es necesario encontrar la causa del mal funcionamiento, pero, identificar el motivo concreto por el que se obtiene un resultado para unos parámetros dados en una función puede llevar horas. Por lo que contar con … [Leer más...] acerca de Depuración de código en Python con Snoop
Solucionar el problema: Recall is ill-defined and being set to 0.0 in labels

abril 8, 2022 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 2 minutos

Al trabajar con modelos de clasificación multiclase es posible que al intentar medir la exhaustividad (recal) en Scikit-learn nos aparezca un mensaje de advertencia del estilo: Recall is ill-defined and being set to 0.0 in labels with no true samples. Este es un problema que aparece porque entre los valores predichos existe una clase que no se observa en el conjunto de valores … [Leer más...] acerca de Solucionar el problema: Recall is ill-defined and being set to 0.0 in labels

Selección condicional con Pandas

abril 4, 2022 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 5 minutos

Al importar un conjunto de datos en una sesión de Python no todos los registros de este tienen porque ser de interés para el análisis que se pretende realizar. Por lo que saber seleccionar los elementos necesarios de una forma rápida es de gran ayuda a la hora de realizar casi cualquier trabajo. Siendo esta una tarea que se puede realizar fácilmente si se aprovechan … [Leer más...] acerca de Selección condicional con Pandas

Seleccionar las mejores características para un modelo con Scikit-learn
abril 1, 2022 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 4 minutos

Cuando trabajamos con conjuntos de datos es habitual que no todas las características sean significativas, por lo que incluirlas puede ser más perjudicial que beneficioso para un modelo de aprendizaje automático. Por eso es importante seleccionar las mejores características. En Scikit-learn existen varias herramientas para ello, siendo una de las más sencillas de utilizar … [Leer más...] acerca de Seleccionar las mejores características para un modelo con Scikit-learn

  • « Ir a la página anterior
  • Página 1
  • Páginas intermedias omitidas …
  • Página 14
  • Página 15
  • Página 16
  • Página 17
  • Página 18
  • Páginas intermedias omitidas …
  • Página 34
  • Ir a la página siguiente »

Barra lateral principal

Suscríbete a nuestro boletín

Suscríbete al boletín semanal para estar al día de todas las publicaciones.

Política de Privacidad

Analytics Lane en redes sociales

  • Amazon
  • Bluesky
  • Facebook
  • GitHub
  • Instagram
  • Mastodon
  • Pinterest
  • RSS
  • Telegram
  • Tumblr
  • Twitter
  • YouTube

Publicidad

Entradas recientes

Por qué migrar tus proyectos TypeScript a ES Modules en 2026

septiembre 17, 2026 Por Daniel Rodríguez

Método del codo: interpretación correcta y limitaciones

septiembre 15, 2026 Por Daniel Rodríguez

Errores comunes al interpretar resultados estadísticos

septiembre 10, 2026 Por Daniel Rodríguez

Publicidad

Es tendencia

  • Curiosidad: La Paradoja de Simpson, o por qué no siempre debes fiarte de los promedios publicado el septiembre 18, 2025 | en Ciencia de datos, Opinión
  • Los mejores conjuntos de datos para Machine Learning publicado el septiembre 11, 2024 | en Ciencia de datos, Reseñas
  • Gráficos de barras en Matplotlib publicado el julio 5, 2022 | en Python
  • Cómo encontrar la posición de elementos en una lista de Python publicado el abril 12, 2021 | en Python
  • Exactitud, precisión, recall… qué mide realmente cada métrica (y qué no) publicado el marzo 3, 2026 | en Ciencia de datos

Publicidad

Lo mejor valorado

4.9 (24)

Seleccionar filas y columnas en Pandas con iloc y loc

4.6 (16)

Archivos JSON con Python: lectura y escritura

4.4 (14)

Ordenación de diccionarios en Python mediante clave o valor

4.7 (13)

Operaciones de filtrado de DataFrame con Pandas en base a los valores de las columnas

4.9 (11)

Pandas: Cambiar los tipos de datos en los DataFrames

Comentarios recientes

  • Daniel Rodríguez en Curiosidad: La Paradoja de Simpson, o por qué no siempre debes fiarte de los promedios
  • Hatepi en Curiosidad: La Paradoja de Simpson, o por qué no siempre debes fiarte de los promedios
  • Daniel Rodríguez en Los récords con asterisco, o la épica del titular sin contexto – El bestiario de los indicadores económicos absurdos (parte 8 y final)
  • Juan en Los récords con asterisco, o la épica del titular sin contexto – El bestiario de los indicadores económicos absurdos (parte 8 y final)
  • bif en JSON en bases de datos: cuándo es buena idea y cuándo no

Publicidad


Footer

Analytics Lane

  • Acerca de Analytics Lane
  • Boletín de noticias
  • Contacto
  • Libros
  • Lo más popular
  • Noticias
  • Tienda
  • Tiendas afiliadas

Secciones

  • Ciencia de datos
  • Criptografía
  • Herramientas
  • Machine Learning
  • Opinión
  • Productividad
  • Programación
  • Reseñas

Sobre de Analytics Lane

En Analytics Lane tratamos de explicar los principales conceptos de la ciencia e ingeniería de datos con un enfoque práctico. Los principales temas tratados son ciencia de datos, ingeniería de datos, inteligencia artificial, machine learning, deep learning y criptografía. Además, también se habla de los principales lenguajes de programación y herramientas utilizadas por los científicos e ingenieros de datos.

Copyright © 2018-2026 Analytics Lane ·Términos y condiciones ·Política de Cookies ·Política de Privacidad ·Herramientas de privacidad ·Contacto