• Saltar al contenido principal
  • Skip to secondary menu
  • Saltar a la barra lateral principal
  • Saltar al pie de página
  • Inicio
  • Secciones
    • Ciencia de datos
    • Criptografía
    • Herramientas
    • Machine Learning
    • Noticias
    • Opinión
    • Productividad
    • Programación
      • JavaScript
      • Julia
      • Matlab
      • Python
      • R
  • Programación
    • JavaScript
    • Julia
    • Matlab
    • Python
    • R
  • Laboratorio
    • Estadística
      • Calculadora del Tamaño Muestral en Encuestas
      • Calculadora de estadísticos descriptivos
      • Test de normalidad
      • Calculadora de contrastes de hipotesis
      • Calculadora de tamano del efecto
      • Simulador de Regresión Lineal con Ruido
      • Visualizador de PCA
      • Visualizador de Series Temporales
      • Simulador de Regresión Logística
      • Simulador de K-Means
      • Simulador de DBSCAN
      • Detector de la Ley de Benford
      • Ajuste de Curvas
      • Calculadora de Matrices
    • Probabilidad
      • Calculadora de Probabilidad de Distribuciones
      • Calculadora de Probabilidades de Lotería
      • Simulador del Problema de Monty Hall
      • Simulador de la Estrategia Martingala
    • Finanzas
      • Calculadora de Préstamos e Hipotecas
      • Conversor TIN ↔ TAE
      • Calculadora DCA con ajuste por inflación
      • Calculadora XIRR con Flujos Irregulares
      • Simulador FIRE (Financial Independence, Retire Early)
    • Negocios
      • CLV
      • Scoring
    • Herramientas
      • Formateador / Minificador de JSON
      • Conversor CSV ↔ JSON
      • Comparador y Formateador de Texto y JSON
      • Formateador y Tester de Expresiones Regulares
      • Inspector de JWT
      • Generador y verificador de hashes
      • Codificador / Decodificador Base64 y URL
      • Conversor de bases numericas
      • Conversor de Timestamp Unix
      • Conversor de colores
      • Generador de UUIDs
    • Juegos
      • Tres en Raya
      • Nim con Q-Learning
    • Más
      • Método D’Hondt
      • Generador de Contraseñas Seguras
  • Noticias
  • Boletín
  • Contacto
  • Tienda
    • Libros
    • Equipamiento de oficina
    • Equipamiento en movilidad

Analytics Lane

Ciencia e ingeniería de datos aplicada

  • Ciencia de datos
  • Machine Learning
  • IA Generativa
  • Python
  • Pandas
  • NumPy
  • R
  • Excel

Truco Python: Importar todas las hojas de un libro Excel con Pandas

marzo 15, 2021 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 2 minutos

Recientemente en los comentarios del blog se ha planteado el problema de cargar todas las hojas de un libro Excel en un único paso. Algo que no se puede hacer con Pandas, ya que el método read_excel() solamente puede importar una hoja. Algo que tiene sentido, ya que en un DataFrame es difícil combinar el contenido de más de una hoja de forma automática. En esta ocasión vamos a … [Leer más...] acerca de Truco Python: Importar todas las hojas de un libro Excel con Pandas

Valores iniciales optimistas para un problema Bandido Multibrazo (Multi-Armed Bandit)
marzo 12, 2021 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 8 minutos

En entradas anteriores hemos aprendido a abordar el problema del Bandido Multibrazo utilizando para ello la estrategia llamada Epsilon-Greedy. Estrategia con la que se obtienen mejores resultados que los de un test A/B. Aunque Epsilon-Greedy tiene un problema cuando el número de episodios a jugar es elevado, continúa explorando los peores bandidos con una probabilidad fija … [Leer más...] acerca de Valores iniciales optimistas para un problema Bandido Multibrazo (Multi-Armed Bandit)

Obtener la media móvil en R

marzo 10, 2021 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 3 minutos

La media móvil es una herramienta que se utiliza habitualmente en análisis de series temporales para eliminar las fluctuaciones a corto plazo. Lo que facilita la observación de las tendencias a largo plazo de la serie. Existen diferentes métodos para calcular la media móvil, siendo el más empleado es media móvil simple (Moving Average), en la que se utilizan la media aritmética … [Leer más...] acerca de Obtener la media móvil en R

Pandas: Seleccionar las primeras o últimas filas de un DataFrame Pandas con head() o tail()
marzo 8, 2021 Por Daniel Rodríguez 1 comentario
Tiempo de lectura: 3 minutos

pandas

Hoy vamos a explicar cómo seleccionar las primeras o últimas filas de un DataFrame, para lo que usaremos las métodos head() y tail().Conjunto de datos de ejemploEn esta ocasión vamos a utilizar el conjunto de datos planets que podemos encontrar en la librería Seaborn. Para importarlos solamente hay que utilizar la función load_dataset() con el nombre de conjunto de … [Leer más...] acerca de Pandas: Seleccionar las primeras o últimas filas de un DataFrame Pandas con head() o tail()

Epsilon-Greedy con decaimiento para un problema Bandido Multibrazo (Multi-Armed Bandit)
marzo 5, 2021 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 7 minutos

La semana pasada vimos cómo se podía usar la estrategia Epsilon-Greedy para resolver un problema tipo bandido multibrazo. Una estrategia que nos había dado mejores resultados que un test A/B. Pero esta estrategia tiene un problema, una vez que se sabe cuál es el mejor bandido se continuará jugando una cantidad de veces con bandidos que no son el óptimo. Lo que se puede resolver … [Leer más...] acerca de Epsilon-Greedy con decaimiento para un problema Bandido Multibrazo (Multi-Armed Bandit)

Diferencias entre library() y require() en R

marzo 3, 2021 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 2 minutos

En R existen dos funciones con las que se puede cargar los paquetes que tenemos instalados en nuestras sesiones: library() y require(). Aunque ambas funciones parece que hacen lo mismo: adjuntan los espacios de nombres de los nuevos paquetes sin recargar los ya cargados. Existen algunas diferencias entre library() y require() que son importante conocer, para utilizar así la más … [Leer más...] acerca de Diferencias entre library() y require() en R

Disponible la versión 1.20.0 de NumPy
marzo 2, 2021 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 2 minutos

Noticias

La versión 1.20.0 se ha liberado recientemente. Versión en la que se incluyen nuevas capacidades como las anotaciones de tipos y expansión del uso de SIMD (single instruction, multiple data). Por lo que se ha descrito como la versión más grande de la historia de la librería.Novedades de la versiónLas anotaciones de tipo se encuentran disponibles en una amplia parte de … [Leer más...] acerca de Disponible la versión 1.20.0 de NumPy

Uso de las f-string de Python para mejorar el formato de textos
marzo 1, 2021 Por Daniel Rodríguez 1 comentario
Tiempo de lectura: 4 minutos

Los literales de cadenas formateados o f-string de Python es una herramienta que facilita crear interpolaciones en cadenas de texto. Simplificando de este modo tanto la lectura como la escritura de estas. Las f-string se introdujo en la versión 3.6 de Python, por lo que es algo relativamente nuevo. Veamos cómo se pueden usar para crear mensajes de una forma más fácil.¿Qué … [Leer más...] acerca de Uso de las f-string de Python para mejorar el formato de textos

Epsilon-Greedy para el Bandido Multibrazo (Multi-Armed Bandit)
febrero 26, 2021 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 6 minutos

La semana pasada hemos visto cómo resolver el problema del Bandido Multibrazo mediante un test A/B. Con el que se jugó con cada uno de los bandidos una cantidad de veces dada hasta que se estaba seguro de cuál era el mejor de los bandidos. Esta aproximación no es eficiente, ya que en muchos casos se puede saber rápidamente cuáles son los peores, por lo que se puede plantear … [Leer más...] acerca de Epsilon-Greedy para el Bandido Multibrazo (Multi-Armed Bandit)

Introducción al paquete dplyr del Tidyverse
febrero 24, 2021 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 7 minutos

Uno de los paquetes que más me gustan del R Tidyverse es dplyr. Un paquete del que no recuerdo cuántos años llevo utilizando para procesar los conjuntos de datos en R. En esta entrada vamos a ver algunas operaciones básicas que se pueden realizar con las funciones de este paquete, para lo que utilizaremos la sintaxis que nos ofrece el operador de tubería (pipe) que vimos la … [Leer más...] acerca de Introducción al paquete dplyr del Tidyverse

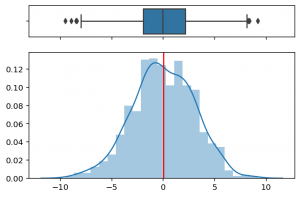
Combinar diagramas de caja e histogramas en Python con Seaborn
febrero 22, 2021 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 3 minutos

Los diagramas de caja ("boxplot") o diagramas de bigote son una excelente herramienta para representar características de un conjunto de datos como la dispersión y la simetría. Otro gráfico que también nos permite observar estas características en los conjuntos de datos son los histogramas. Por lo que, en ciertas ocasiones, puede ser una buena idea combinar ambos en un único … [Leer más...] acerca de Combinar diagramas de caja e histogramas en Python con Seaborn

Test A/B para el Bandido Multibrazo (Multi-Armed Bandit)
febrero 19, 2021 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 4 minutos

Recientemente hemos visto el problema del Bandido Multibrazo (Multi-Armed Bandit). Una de las posibles soluciones que tenemos en nuestra mano para resolver este problema es utilizar un Test A/B. Esto es, evaluar durante un periodo de tiempo todos los bandidos por igual y decidir una vez finalizado este periodo de prueba cuál es el óptimo. O, si los datos no son concluyentes, … [Leer más...] acerca de Test A/B para el Bandido Multibrazo (Multi-Armed Bandit)

  • « Ir a la página anterior
  • Página 1
  • Páginas intermedias omitidas …
  • Página 66
  • Página 67
  • Página 68
  • Página 69
  • Página 70
  • Páginas intermedias omitidas …
  • Página 105
  • Ir a la página siguiente »

Barra lateral principal

Suscríbete a nuestro boletín

Suscríbete al boletín semanal para estar al día de todas las publicaciones.

Política de Privacidad

Analytics Lane en redes sociales

  • Amazon
  • Bluesky
  • Facebook
  • GitHub
  • Instagram
  • Mastodon
  • Pinterest
  • RSS
  • Telegram
  • Tumblr
  • Twitter
  • YouTube

Publicidad

Entradas recientes

Por qué migrar tus proyectos TypeScript a ES Modules en 2026

septiembre 17, 2026 Por Daniel Rodríguez

Método del codo: interpretación correcta y limitaciones

septiembre 15, 2026 Por Daniel Rodríguez

Errores comunes al interpretar resultados estadísticos

septiembre 10, 2026 Por Daniel Rodríguez

Publicidad

Es tendencia

  • Curiosidad: La Paradoja de Simpson, o por qué no siempre debes fiarte de los promedios publicado el septiembre 18, 2025 | en Ciencia de datos, Opinión
  • Guardar diferentes hojas Excel con Python publicado el julio 6, 2020 | en Python
  • pandas Pandas: Cómo iterar sobre las filas de un DataFrame en Pandas publicado el septiembre 13, 2021 | en Python
  • Exactitud, precisión, recall… qué mide realmente cada métrica (y qué no) publicado el marzo 3, 2026 | en Ciencia de datos
  • Uso de Parquet para guardar los conjuntos de datos de forma eficiente en Pandas publicado el diciembre 20, 2021 | en Python

Publicidad

Lo mejor valorado

4.9 (24)

Seleccionar filas y columnas en Pandas con iloc y loc

4.6 (16)

Archivos JSON con Python: lectura y escritura

4.4 (14)

Ordenación de diccionarios en Python mediante clave o valor

4.7 (13)

Operaciones de filtrado de DataFrame con Pandas en base a los valores de las columnas

4.9 (11)

Pandas: Cambiar los tipos de datos en los DataFrames

Comentarios recientes

  • Daniel Rodríguez en Curiosidad: La Paradoja de Simpson, o por qué no siempre debes fiarte de los promedios
  • Hatepi en Curiosidad: La Paradoja de Simpson, o por qué no siempre debes fiarte de los promedios
  • Daniel Rodríguez en Los récords con asterisco, o la épica del titular sin contexto – El bestiario de los indicadores económicos absurdos (parte 8 y final)
  • Juan en Los récords con asterisco, o la épica del titular sin contexto – El bestiario de los indicadores económicos absurdos (parte 8 y final)
  • bif en JSON en bases de datos: cuándo es buena idea y cuándo no

Publicidad


Footer

Analytics Lane

  • Acerca de Analytics Lane
  • Boletín de noticias
  • Contacto
  • Libros
  • Lo más popular
  • Noticias
  • Tienda
  • Tiendas afiliadas

Secciones

  • Ciencia de datos
  • Criptografía
  • Herramientas
  • Machine Learning
  • Opinión
  • Productividad
  • Programación
  • Reseñas

Sobre de Analytics Lane

En Analytics Lane tratamos de explicar los principales conceptos de la ciencia e ingeniería de datos con un enfoque práctico. Los principales temas tratados son ciencia de datos, ingeniería de datos, inteligencia artificial, machine learning, deep learning y criptografía. Además, también se habla de los principales lenguajes de programación y herramientas utilizadas por los científicos e ingenieros de datos.

Copyright © 2018-2026 Analytics Lane ·Términos y condiciones ·Política de Cookies ·Política de Privacidad ·Herramientas de privacidad ·Contacto