• Saltar al contenido principal
  • Skip to secondary menu
  • Saltar a la barra lateral principal
  • Saltar al pie de página
  • Inicio
  • Secciones
    • Ciencia de datos
    • Criptografía
    • Herramientas
    • Machine Learning
    • Noticias
    • Opinión
    • Productividad
    • Programación
      • JavaScript
      • Julia
      • Matlab
      • Python
      • R
  • Programación
    • JavaScript
    • Julia
    • Matlab
    • Python
    • R
  • Laboratorio
    • Estadística
      • Calculadora del Tamaño Muestral en Encuestas
      • Calculadora de estadísticos descriptivos
      • Test de normalidad
      • Calculadora de contrastes de hipotesis
      • Calculadora de tamano del efecto
      • Simulador de Regresión Lineal con Ruido
      • Visualizador de PCA
      • Visualizador de Series Temporales
      • Simulador de Regresión Logística
      • Simulador de K-Means
      • Simulador de DBSCAN
      • Detector de la Ley de Benford
      • Ajuste de Curvas
      • Calculadora de Matrices
    • Probabilidad
      • Calculadora de Probabilidad de Distribuciones
      • Calculadora de Probabilidades de Lotería
      • Simulador del Problema de Monty Hall
      • Simulador de la Estrategia Martingala
    • Finanzas
      • Calculadora de Préstamos e Hipotecas
      • Conversor TIN ↔ TAE
      • Calculadora DCA con ajuste por inflación
      • Calculadora XIRR con Flujos Irregulares
      • Simulador FIRE (Financial Independence, Retire Early)
    • Negocios
      • CLV
      • Scoring
    • Herramientas
      • Formateador / Minificador de JSON
      • Conversor CSV ↔ JSON
      • Comparador y Formateador de Texto y JSON
      • Formateador y Tester de Expresiones Regulares
      • Inspector de JWT
      • Generador y verificador de hashes
      • Codificador / Decodificador Base64 y URL
      • Conversor de bases numericas
      • Conversor de Timestamp Unix
      • Conversor de colores
      • Generador de UUIDs
    • Juegos
      • Tres en Raya
      • Nim con Q-Learning
    • Más
      • Método D’Hondt
      • Generador de Contraseñas Seguras
  • Noticias
  • Boletín
  • Contacto
  • Tienda
    • Libros
    • Equipamiento de oficina
    • Equipamiento en movilidad

Analytics Lane

Ciencia e ingeniería de datos aplicada

  • Ciencia de datos
  • Machine Learning
  • IA Generativa
  • Python
  • Pandas
  • NumPy
  • R
  • Excel

Ciencia de datos

La ciencia de datos es un área de conocimiento interdisciplinar en el cual se utilizan procesos para recopilar, preparar, analizar, visualizar y modelar datos para extraer todo su valor. Pudiéndose emplear tanto con conjuntos de datos estructurados como no estructurados. Los científicos de datos, los profesionales de esta área deben poseer grandes conocimientos de estadística e informática. Además de conocimiento de los procesos que están modelando.

Con la ciencia de datos es posible revelar tendencias y obtener información para que tanto las empresas como las instituciones puedan tomar mejores decisiones. Basando estas así en conocimiento validado no en intuiciones.

Las publicaciones de esta sección abarca diferentes temas de áreas como la estadística, la minería de datos, el aprendizaje automático y la analítica predictiva.

El método de la secante e implementación en Python

junio 17, 2022 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 4 minutos

Un algoritmo alternativo al de la bisección para la búsqueda de raíces es el método de la secante. Generalmente es un método más eficiente ya que, mientras el primero utiliza el punto intermedio para buscar el punto de corte y aproximar la raíz, el método de la secante emplea como aproximación la secante para buscar la solución. Siendo esta una aproximación de la forma de la … [Leer más...] acerca de El método de la secante e implementación en Python

Representar los criterios de selección en árboles de decisión
junio 3, 2022 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 3 minutos

La representación de árboles de decisión es un tema del que ya se ha publicado con antelación en el blog. En su momento de ha visto los pasos necesarios para generar representaciones gráficas y de texto con las librerías PyDotPlus y Scikit-Learn. Aunque también existen otras librerías como dtreeviz, la que veremos hoy. Una librería con la que es posible representar los … [Leer más...] acerca de Representar los criterios de selección en árboles de decisión

Factores que pueden afectar a la elasticidad de la demanda

mayo 27, 2022 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 4 minutos

La elasticidad de la demanda es un parámetro clave a la hora de fijar los precios de un bien o servicio. Aumentar el precio de una referencia elástica puede hacer que la demanda se reduzca demasiado afectando a las estimaciones. Mientras que en las referencias inelásticas la variación es menor. Pero el precio no es el único factor que puede afectar a la elasticidad de la … [Leer más...] acerca de Factores que pueden afectar a la elasticidad de la demanda

Tipos de elasticidad de la demanda en función del precio

mayo 20, 2022 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 3 minutos

La variación que sufre la demanda ante un cambio de precio es lo que se conoce en económica como elasticidad, un valor clave que se debe tener en cuenta a la hora de fijar los precios de un bien o servicio. Pero ¿qué tipos de elasticidad de la demanda existen?ElasticidadLa elasticidad se define como la variación observada en la demanda de un producto o servicio respecto … [Leer más...] acerca de Tipos de elasticidad de la demanda en función del precio
Solucionar el problema: Recall is ill-defined and being set to 0.0 in labels

abril 8, 2022 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 2 minutos

Al trabajar con modelos de clasificación multiclase es posible que al intentar medir la exhaustividad (recal) en Scikit-learn nos aparezca un mensaje de advertencia del estilo: Recall is ill-defined and being set to 0.0 in labels with no true samples. Este es un problema que aparece porque entre los valores predichos existe una clase que no se observa en el conjunto de valores … [Leer más...] acerca de Solucionar el problema: Recall is ill-defined and being set to 0.0 in labels

Seleccionar las mejores características para un modelo con Scikit-learn
abril 1, 2022 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 4 minutos

Cuando trabajamos con conjuntos de datos es habitual que no todas las características sean significativas, por lo que incluirlas puede ser más perjudicial que beneficioso para un modelo de aprendizaje automático. Por eso es importante seleccionar las mejores características. En Scikit-learn existen varias herramientas para ello, siendo una de las más sencillas de utilizar … [Leer más...] acerca de Seleccionar las mejores características para un modelo con Scikit-learn

Representar árboles de decisiones con Scikit-Learn
marzo 14, 2022 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 3 minutos

Los árboles de decisión son una familia de algoritmos de aprendizaje supervisados ampliamente utilizados debido a que, a pesar de su simplicidad, pueden realizan buenas predicciones en una amplia variedad de problemas. Además, la simplicidad de su planteamiento hace que sus resultados sean fácilmente interpretables. Permitiendo no solo obtener predicciones relevantes, sino … [Leer más...] acerca de Representar árboles de decisiones con Scikit-Learn

El método de la bisección e implementación en Python

marzo 11, 2022 Por Daniel Rodríguez 2 comentarios
Tiempo de lectura: 4 minutos

Uno de los métodos numéricos para buscar la raíz de una función más sencillo es el de la bisección. Siendo también uno de los más fáciles de implementar en un programa. El método de la bisección se puede utilizar en funciones continuas que cambian de signo en un rango de valores y solamente tienen una raíz en el mismo. Basándose para ello en una idea sencilla: dividir el rango … [Leer más...] acerca de El método de la bisección e implementación en Python

Calcular el número óptimo de bins para un histograma
febrero 25, 2022 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 4 minutos

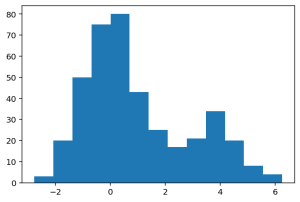
Histograma generado para el conjunto de datos con la selección automática del número de bins

Los histogramas son una herramienta fantástica para visualizar la frecuencia de los diferentes valores de un conjunto de datos. Permitiendo ver rápidamente la distribución de la población. Lo que se hace dividiendo el rango del conjunto de datos en grupos de la misma anchura, a los que se suelen denominar bins, y contar el número de valores que caen en cada uno de estos. Siendo … [Leer más...] acerca de Calcular el número óptimo de bins para un histograma

¿Es sostenible la ciencia de datos basada en Software Libre?

febrero 18, 2022 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 4 minutos

A finales del año pasado saltaba la noticia de la existencia de una vulnerabilidad crítica en Apache Log4j, afectando a millones de aplicaciones y servicios que usaban esta librería para la creación de los logs. Poniendo en jaque a miles de pequeñas, medianas y grandes empresas. La gravedad del fallo de seguridad se puede ver en el hecho de que la noticia ha llegado a las … [Leer más...] acerca de ¿Es sostenible la ciencia de datos basada en Software Libre?

Escalabilidad para Machine Learning
febrero 4, 2022 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 3 minutos

El concepto de escalabilidad es algo cada día más importante a la hora de desarrollar nuevas soluciones tecnológicas, incluidas en las que se implementan modelos de Aprendizaje Automático o Machine Learning. De poco sirve disponer del mejor modelo si cuando es necesario no es posible escalar para responder a toda la demanda. Esto es, si no se puede resolver en plazo todas las … [Leer más...] acerca de Escalabilidad para Machine Learning

Los tipos de aprendizaje por conjuntos (Ensemble Learning)
enero 28, 2022 Por Daniel Rodríguez Deja un comentario
Tiempo de lectura: 4 minutos

Al evaluar y comparar el rendimiento de diferentes modelos de aprendizaje automático es habitual observar que las mejores predicciones no siempre proceden del mismo modelo. En un subconjunto de datos los mejores resultados los ofrece la regresión lineal, pero en otro funcionan mejor los árboles de decisión. Lo que indica que el mejor modelo sería una combinación de los mejores. … [Leer más...] acerca de Los tipos de aprendizaje por conjuntos (Ensemble Learning)

  • « Ir a la página anterior
  • Página 1
  • Páginas intermedias omitidas …
  • Página 10
  • Página 11
  • Página 12
  • Página 13
  • Página 14
  • Páginas intermedias omitidas …
  • Página 19
  • Ir a la página siguiente »

Barra lateral principal

Suscríbete a nuestro boletín

Suscríbete al boletín semanal para estar al día de todas las publicaciones.

Política de Privacidad

Analytics Lane en redes sociales

  • Amazon
  • Bluesky
  • Facebook
  • GitHub
  • Instagram
  • Mastodon
  • Pinterest
  • RSS
  • Telegram
  • Tumblr
  • Twitter
  • YouTube

Publicidad

Entradas recientes

Errores comunes al interpretar resultados estadísticos

septiembre 10, 2026 Por Daniel Rodríguez

Dashboard CLV: cuatro modelos, un mismo dataset, conclusiones muy distintas

septiembre 8, 2026 Por Daniel Rodríguez

Curiosidad: Por qué la criptografía habla siempre de Alice y Bob

septiembre 3, 2026 Por Daniel Rodríguez

Publicidad

Es tendencia

  • Realizar auditorías de código Python automáticamente publicado el junio 13, 2022 | en Python
  • Gráficos de correlación en Seaborn: Mapas de calor y gráficos de pares publicado el julio 27, 2023 | en Python
  • Histograma generado para el conjunto de datos con la selección automática del número de bins Calcular el número óptimo de bins para un histograma publicado el febrero 25, 2022 | en Ciencia de datos
  • Ratios para evaluar fondos de inversión y ETFs: Sharpe, Sortino, Treynor y Alpha de Jensen publicado el marzo 7, 2025 | en Ciencia de datos
  • Curiosidad: ¿Por qué usamos p < 0.05? Un umbral que cambió la historia de la ciencia publicado el octubre 2, 2025 | en Ciencia de datos, Opinión

Publicidad

Lo mejor valorado

4.9 (24)

Seleccionar filas y columnas en Pandas con iloc y loc

4.6 (16)

Archivos JSON con Python: lectura y escritura

4.4 (14)

Ordenación de diccionarios en Python mediante clave o valor

4.7 (13)

Operaciones de filtrado de DataFrame con Pandas en base a los valores de las columnas

4.9 (11)

Pandas: Cambiar los tipos de datos en los DataFrames

Comentarios recientes

  • Daniel Rodríguez en Los récords con asterisco, o la épica del titular sin contexto – El bestiario de los indicadores económicos absurdos (parte 8 y final)
  • Juan en Los récords con asterisco, o la épica del titular sin contexto – El bestiario de los indicadores económicos absurdos (parte 8 y final)
  • bif en JSON en bases de datos: cuándo es buena idea y cuándo no
  • bif en Cómo desinstalar Oracle Database 19c en Windows
  • M. Pilar en Cómo eliminar las noticias en Windows 11 y recuperar tu concentración

Publicidad


Footer

Analytics Lane

  • Acerca de Analytics Lane
  • Boletín de noticias
  • Contacto
  • Libros
  • Lo más popular
  • Noticias
  • Tienda
  • Tiendas afiliadas

Secciones

  • Ciencia de datos
  • Criptografía
  • Herramientas
  • Machine Learning
  • Opinión
  • Productividad
  • Programación
  • Reseñas

Sobre de Analytics Lane

En Analytics Lane tratamos de explicar los principales conceptos de la ciencia e ingeniería de datos con un enfoque práctico. Los principales temas tratados son ciencia de datos, ingeniería de datos, inteligencia artificial, machine learning, deep learning y criptografía. Además, también se habla de los principales lenguajes de programación y herramientas utilizadas por los científicos e ingenieros de datos.

Copyright © 2018-2026 Analytics Lane ·Términos y condiciones ·Política de Cookies ·Política de Privacidad ·Herramientas de privacidad ·Contacto